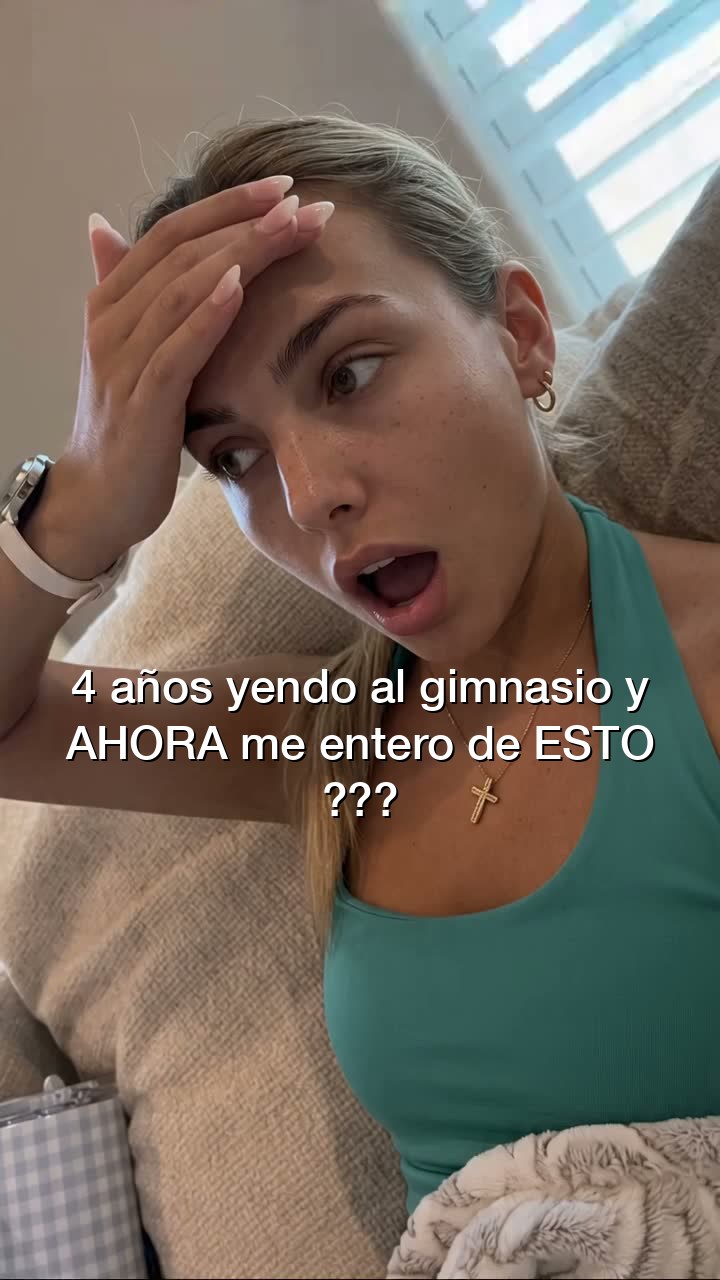
 ejemplo · lo escribe él en TikTok
b-roll: FUERZARECORRIDO faltan: HOME
Canal Reposters · de un vídeo que ya funcionó en TikTok al MP4 que sube el reposter. Siete pasos.

Un vídeo que ya funcionó en TikTok. De ahí sale el gesto.

De ese vídeo se congela el segundo 0. Es la foto que manda.

La IA cambia la persona en esa foto. Misma pose, otra cara.

Se anima la foto usando el vídeo de TikTok como coreografía.
La tabla dice qué frase puede ir y con qué b-roll.

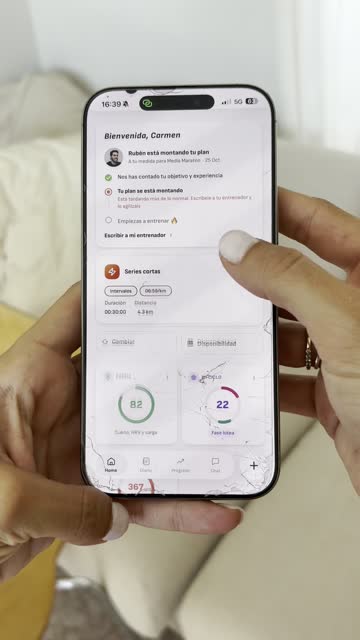
Cara delante, b-roll de la app detrás. Un solo MP4.

No va quemado: el reposter lo escribe desde la plataforma.
Gesto 01 con la cara de IA, y detrás el b-roll de RECORRIDO LARGO. Corte seco, sin transición. Sale limpia: el texto lo pone después el operador.
1080×1920 · 30 fps · 18 s
Los cuatro gestos vienen de vídeos que ya reventaron en TikTok. Tres referencias por gesto, doce en total: son los mismos doce que ve la modelo en el rodaje.
@kailyn.lifts · 13,7M de visualizaciones. Lo que se copia es el recorte de los primeros segundos: el gesto, no el vídeo entero.
| 01 | Mano en la cara | @kailyn.lifts ↗TikTok | 13,7M | 0,56% |
| 02 | Se tapa la boca | @honousmitfv ↗TikTok | 1,2M | 6,70% |
| 03 | Sorpresa contenida | @danclipping ↗X | n/d | n/d |
| 04 | No me lo creo | @sarafinalyfts ↗TikTok | 2,7M | 3,17% |
| 05 | Mano en la cara | @sarafinalyfts ↗TikTok | 4,9M | 0,60% |
| 06 | Se tapa la boca | @julesshufl ↗TikTok | 827,5K | 13,60% |
| 07 | Sorpresa contenida | @klaraa.ipod ↗TikTok | 17,6K | 3,68% |
| 08 | No me lo creo | @klaraa.ipod ↗TikTok | 1,2M | 15,23% |
| 09 | Mano en la cara | @klaraa.ipod ↗TikTok | 816,8K | 9,17% |
| 10 | Se tapa la boca | @sarafinalyfts ↗TikTok | 132,9K | 0,69% |
| 11 | Sorpresa contenida | @sophiaas.mp3 ↗TikTok | 20,7K | 3,65% |
| 12 | No me lo creo | @kailyn.lifts ↗TikTok | 348,7K | 0,44% |
La cara que se le pasa a la IA junto al fotograma. No es nadie: son híbridos generados, nunca la copia de una persona real. Son las tres de la versión V3 — la que funciona — y valen para todos los clips: se generan una vez y se reutilizan.
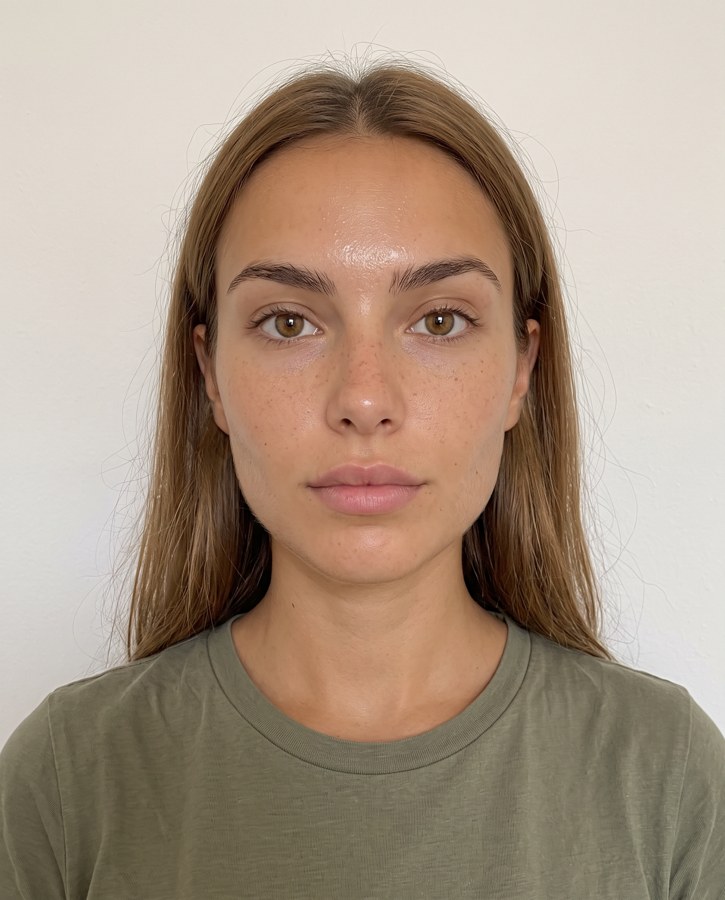
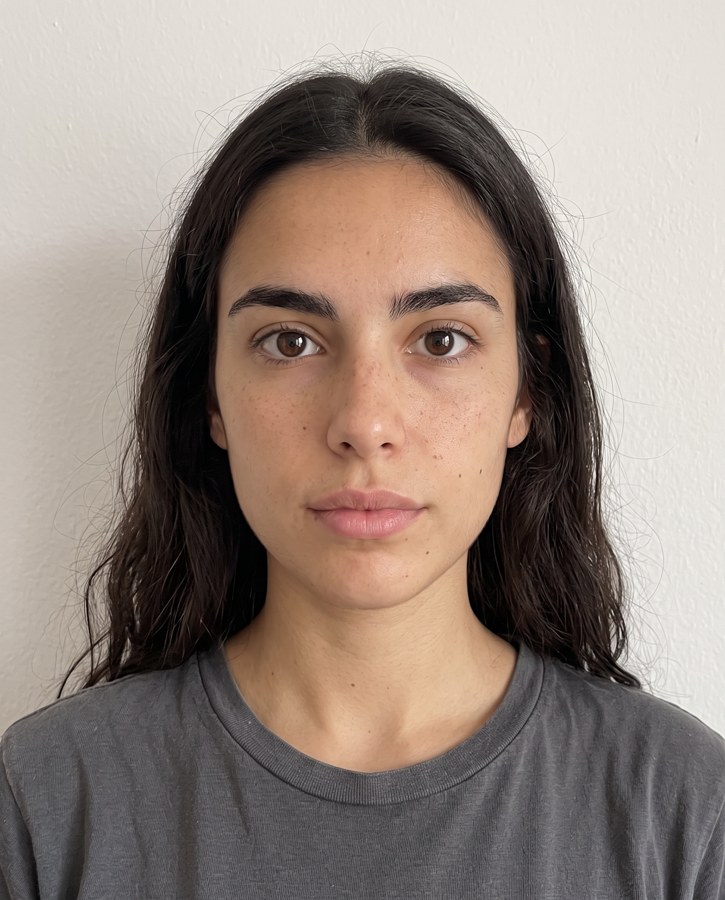
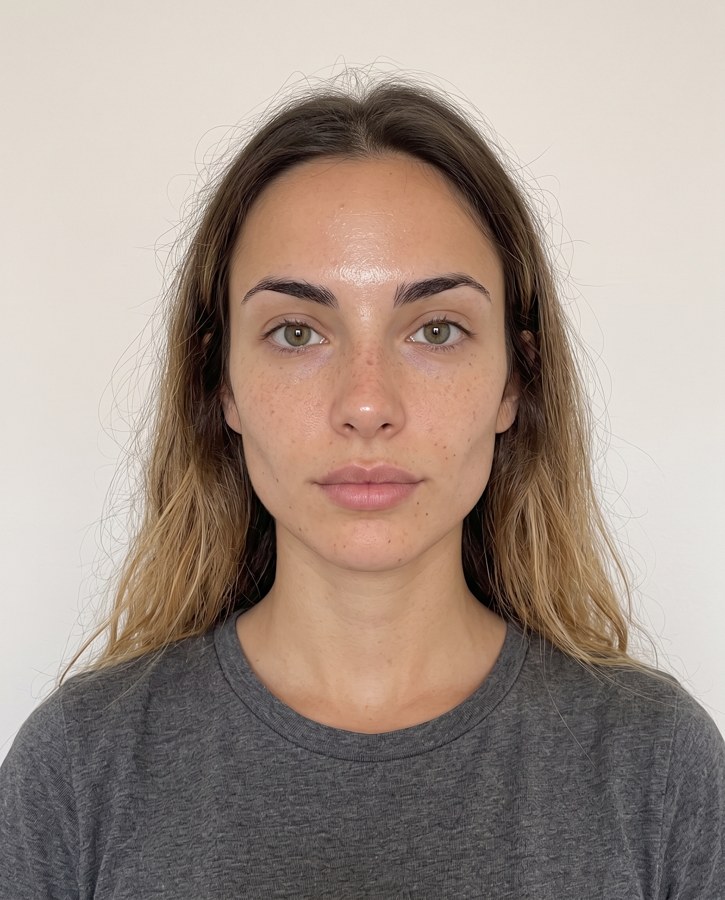
Por qué V3 y no las anteriores: misma geometría que V2, pero cambia la foto, no la cara — foto de carnet en casa, camiseta lisa, luz plana que no modela, pecas y alguna marca mínima. Eso es lo que la hace creíble; las versiones con luz de estudio salían más guapas y con aire de prueba de modelo.
Los 12 enlaces están en la tabla de arriba. Once de TikTok y uno de X (@danclipping).
https://crm-whatsapp.vm.runnerpro.app/rodaje.html
En la VM: /home/cristobal/crm-whatsapp-reporters/src/public/rodaje.html — los 12 clips van dentro del propio HTML, recortados y en bucle (01_Mano_en_la_cara.mp4 … 12_No_me_lo_creo.mp4).
1-Proyectos/MARKETING/CANAL_REPOSTERS/REFERENCIAS_RODAJE_12_GESTOS.html
Cada referencia con su fotograma 0, sus vistas y su engagement, leídos el 16-sep-2026.
/Users/cristobal/Library/Mobile Documents/com~apple~CloudDocs/ACTIVE/Reposters/TANDA VIDEOS - BROLLS /
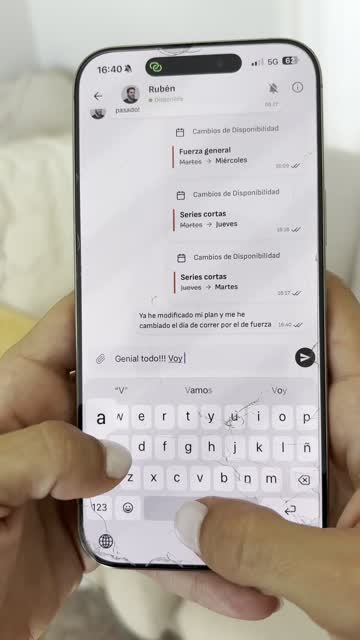
Cinco carpetas: PLAN, HOME, ESCÁNER - NUTRI, FUERZA, RECORRIDO LARGO.
media/cara_base3_A.jpg · _B.jpg · _C.jpg
En el vault: CANAL_REPOSTERS/CARA_SINTETICA/media/c/base_v3_A|B|C.jpg
~/projects/codigo/tanda-brolls/ · entrada_ia/ → salida/
matriz.json, cruce.py, monta.py, ejemplo_rotulo.py. Todo el código está abajo.
iCloud Drive, una carpeta por funcionalidad de la app. El vídeo concreto dentro de la carpeta da igual: se rotan para que salgan todos las mismas veces.
/Users/cristobal/Library/Mobile Documents/com~apple~CloudDocs/ACTIVE/Reposters/TANDA VIDEOS - BROLLS /
…/TANDA VIDEOS - BROLLS /PLAN…/TANDA VIDEOS - BROLLS /HOME …/TANDA VIDEOS - BROLLS /ESCÁNER - NUTRI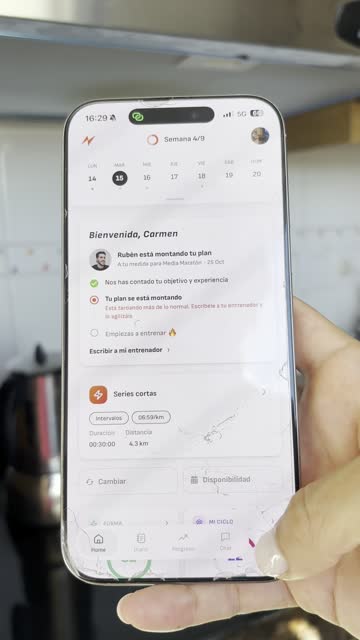
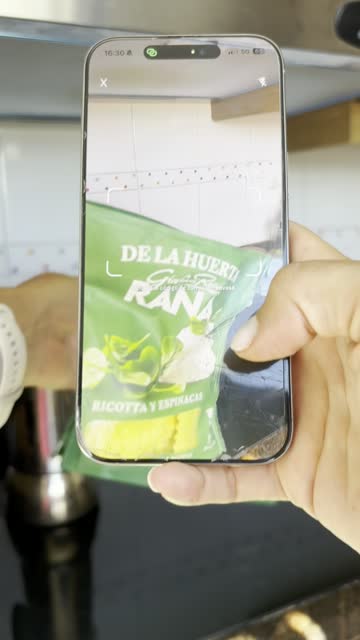
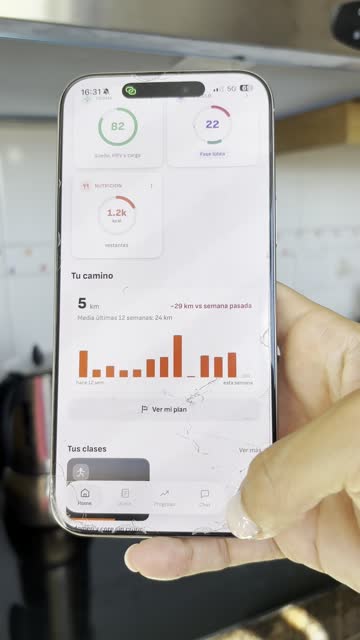
…/TANDA VIDEOS - BROLLS /FUERZA 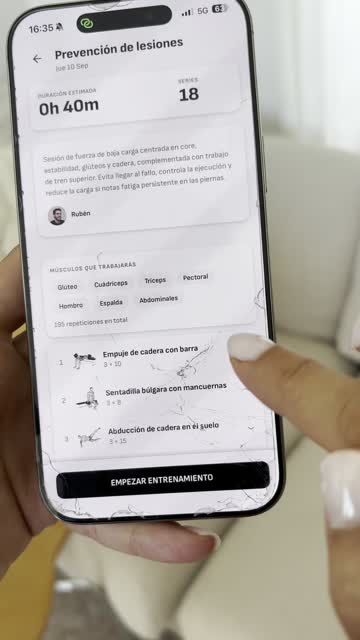
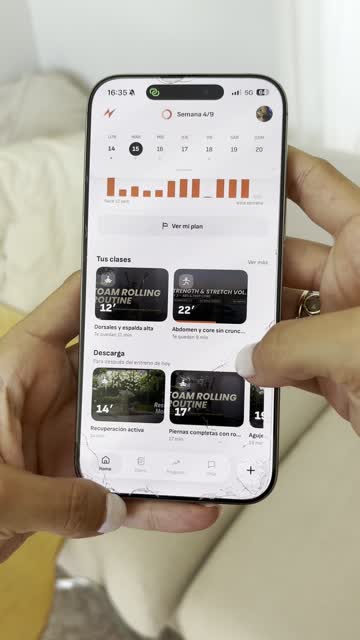
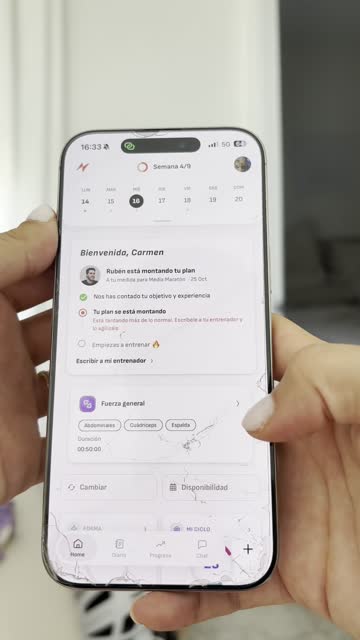
…/TANDA VIDEOS - BROLLS /RECORRIDO LARGO 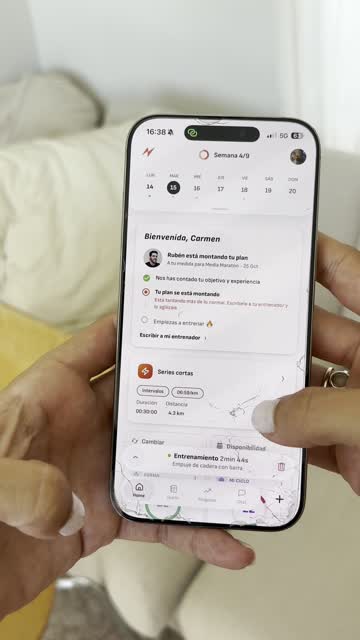
| Frase | Semántica | Plan | Home | Escáner | Fuerza | Recorrido |
|---|---|---|---|---|---|---|
| 4 años yendo al gimnasio y AHORA me entero de ESTO ??? | AGRAVIO | — | ✓ | — | ● | ✓ |
| 2 años corriendo y NADIE me había dicho ESTO ??! | AGRAVIO | ● | ✓ | — | — | ✓ |
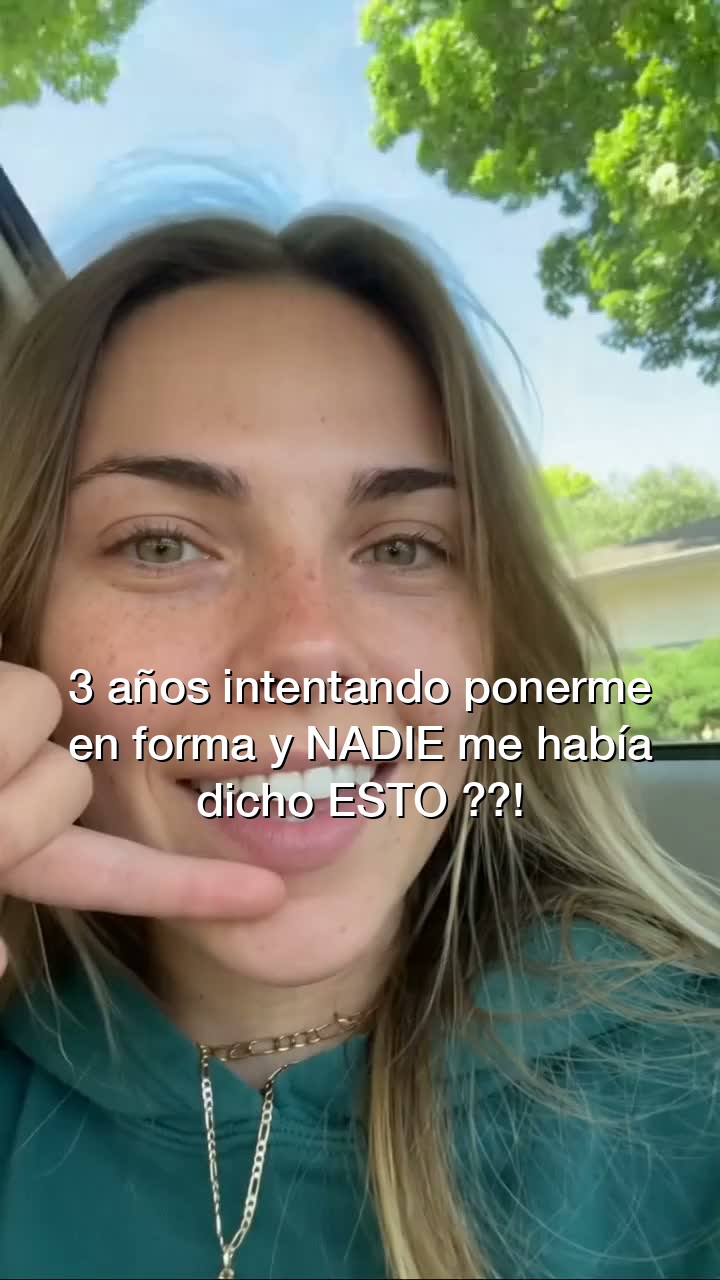
| 3 años intentando ponerme en forma y NADIE me había dicho ESTO ??! | AGRAVIO | ✓ | ✓ | ✓ | ✓ | ✓ |
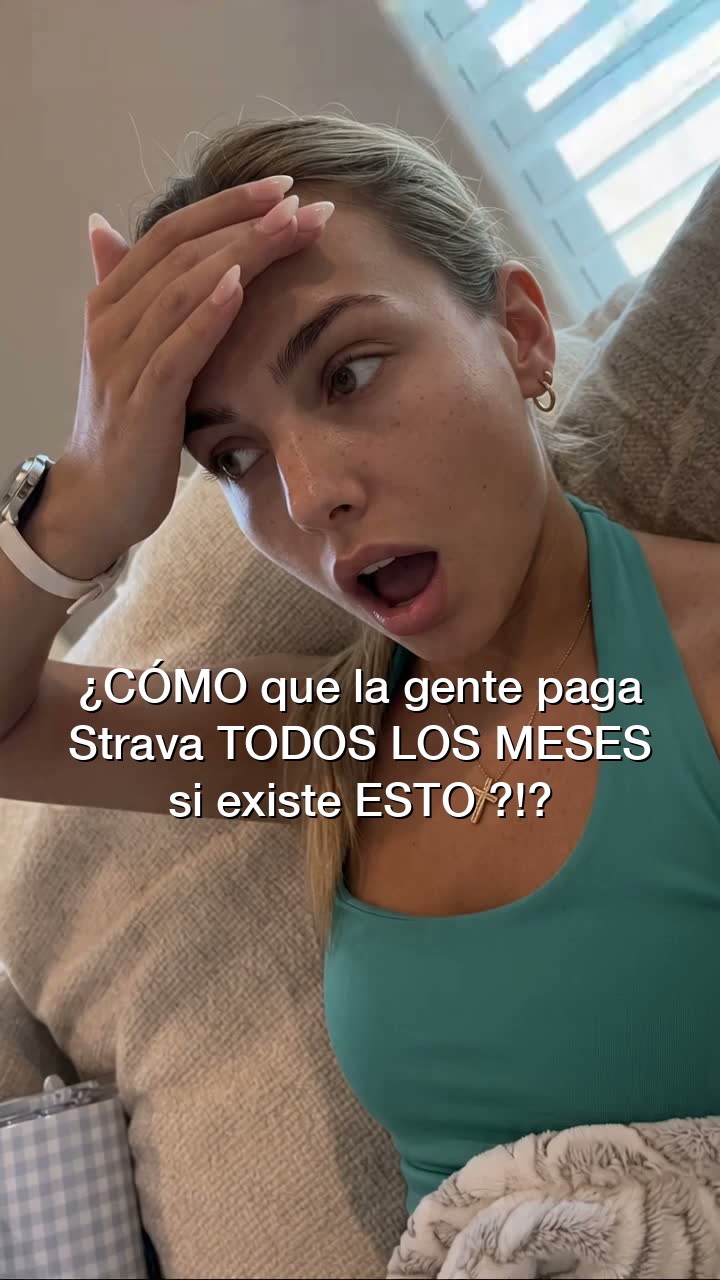
| ¿CÓMO que la gente paga Strava TODOS LOS MESES si existe ESTO ?!? | PAGA X | ● | ✓ | — | — | ✓ |
| CÓMOOOO no conocía esto >> | CÓMOOO | ✓ | ✓ | ✓ | ✓ | ✓ |
| CÓMOOOO no conocía esto siendo runner >> | CÓMOOO | ● | ✓ | — | — | ✓ |
| Si corres y no sigues ningún plan, TIENES que ver ESTO 🤯 | CONDICIONAL | ● | ✓ | — | — | ✓ |
| Si quieres empezar a correr, TIENES que ver ESTO | CONDICIONAL | ● | ✓ | — | — | ✓ |
| ¿CÓMO QUE existe ESTO y no lo sabía nadie ??? | INCREDULIDAD | ✓ | ✓ | ✓ | ✓ | ✓ |
| Esto no puede ser real ??? | INCREDULIDAD | ✓ | ✓ | ✓ | ✓ | ✓ |
Tres cosas por pieza: el MP4 limpio, el texto para copiar, y el fotograma de ejemplo con la frase puesta donde va — centrada, blanca, sin caja. Él la escribe con el texto nativo de TikTok.
ejemplo · lo escribe él en TikTok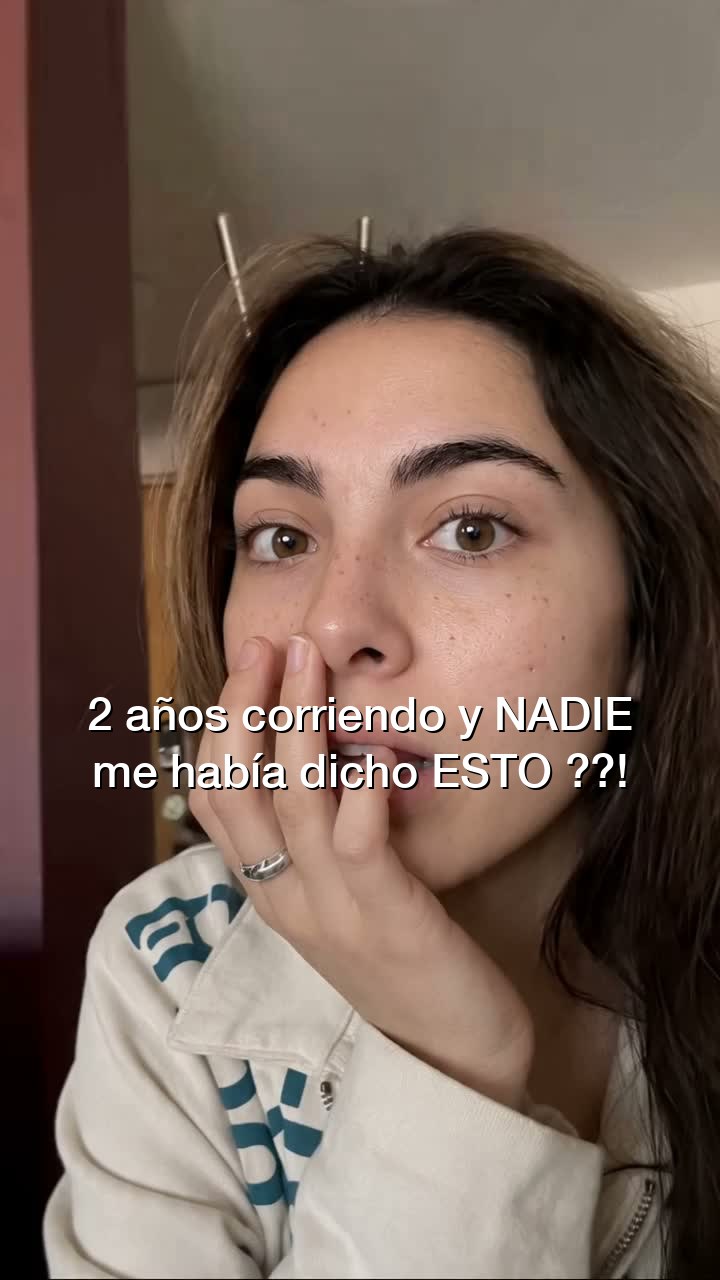 ejemplo · lo escribe él en TikTok
 ejemplo · lo escribe él en TikTok
 ejemplo · lo escribe él en TikTok
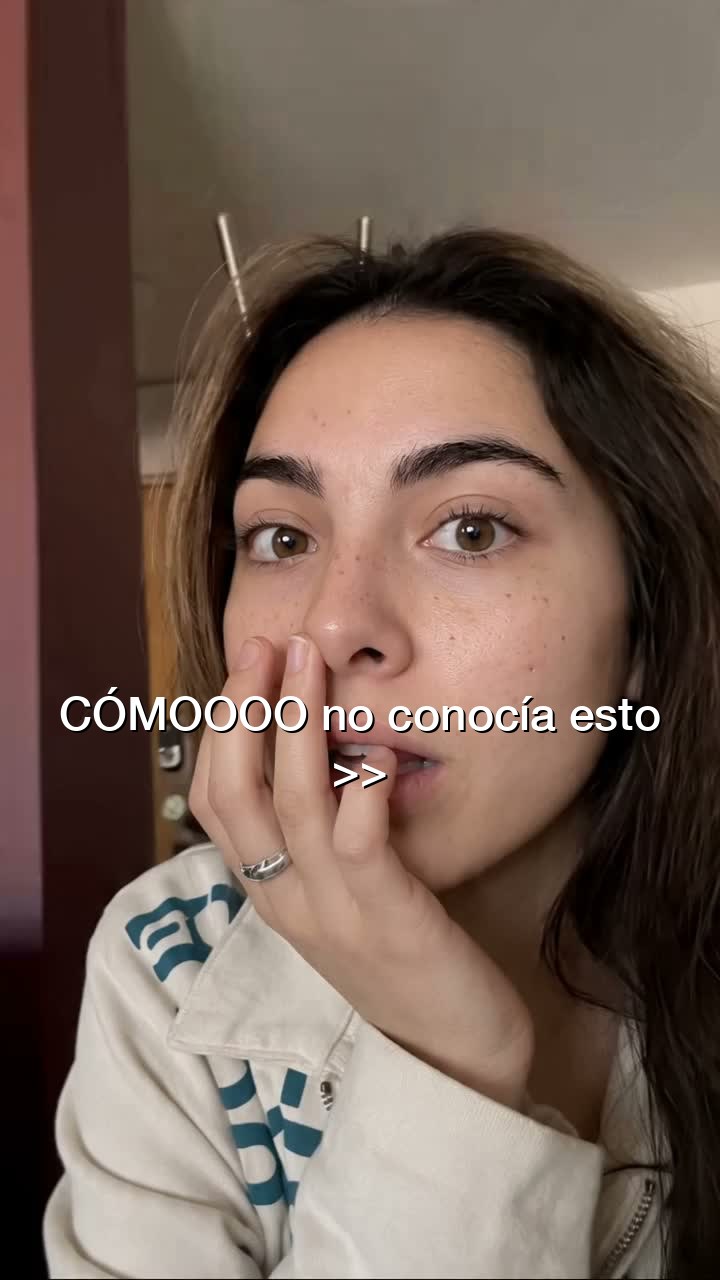 ejemplo · lo escribe él en TikTok
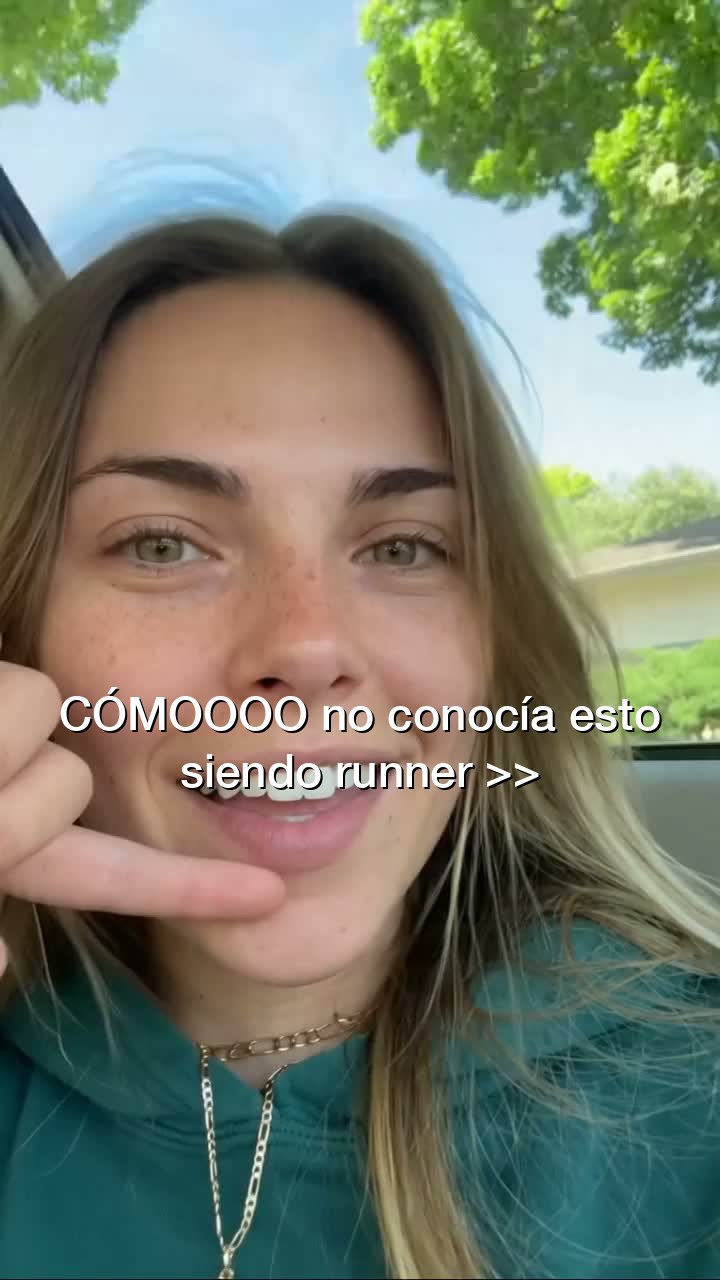 ejemplo · lo escribe él en TikTok
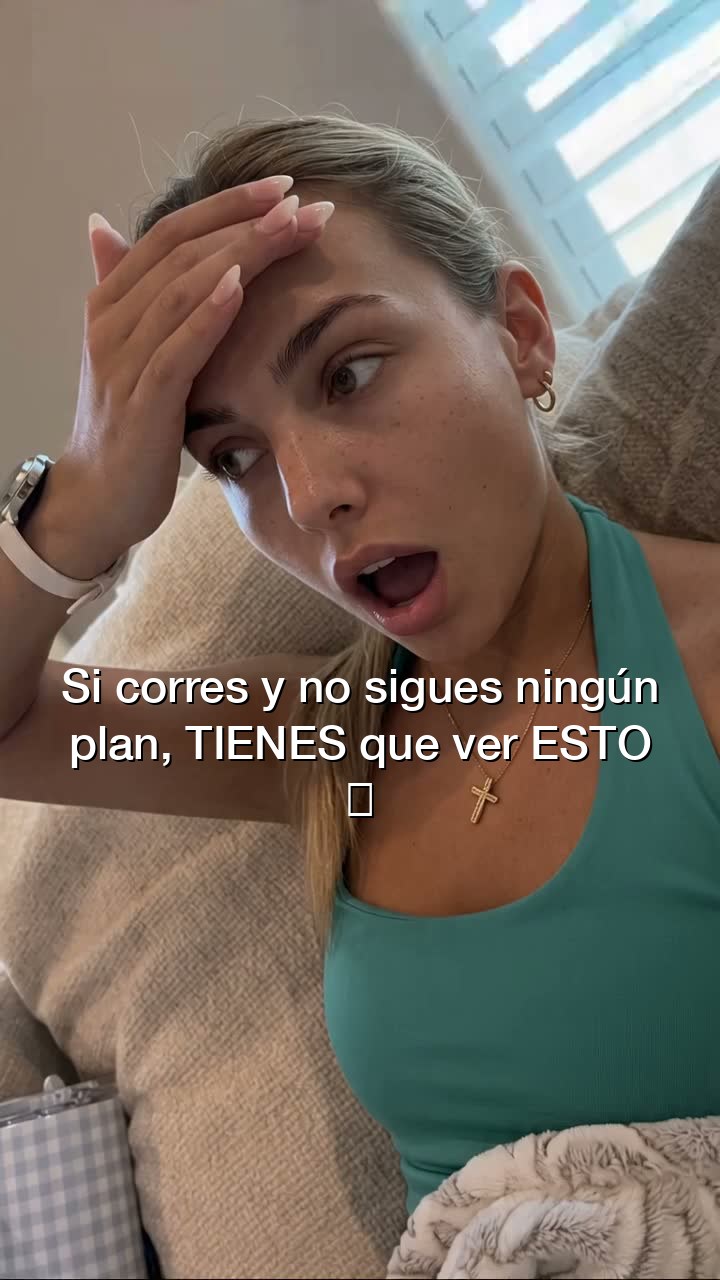 ejemplo · lo escribe él en TikTok
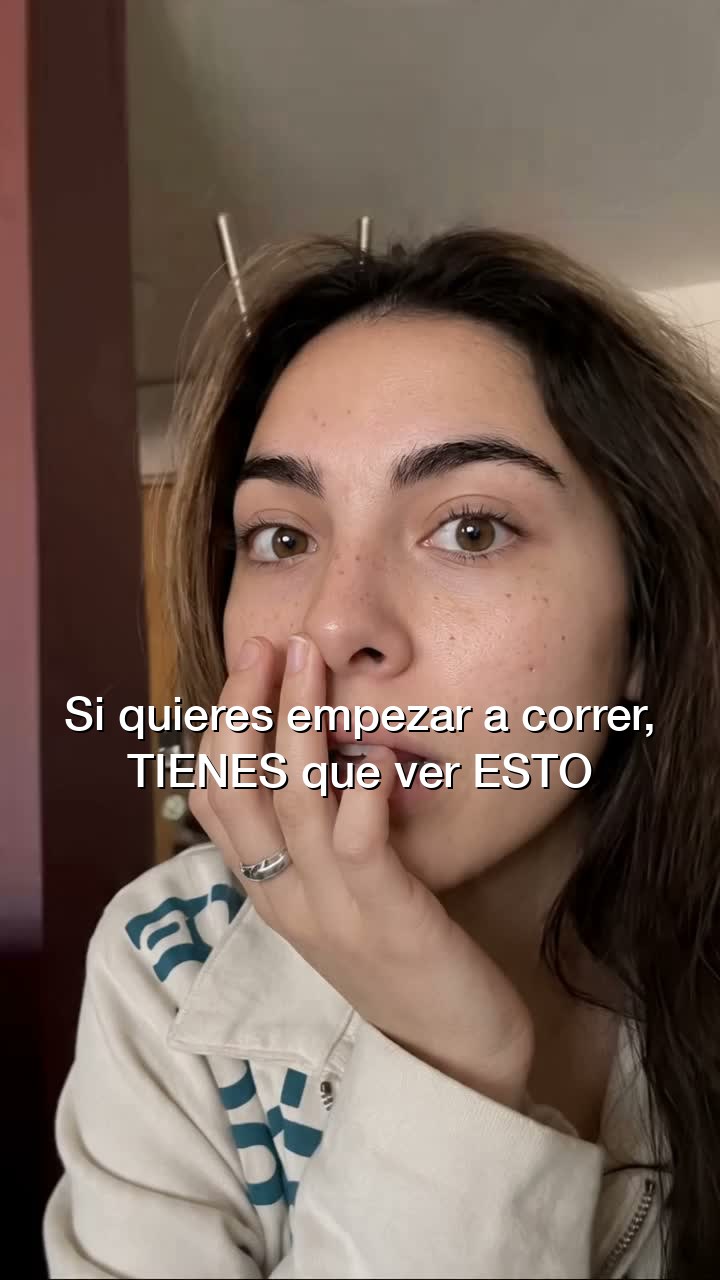 ejemplo · lo escribe él en TikTok
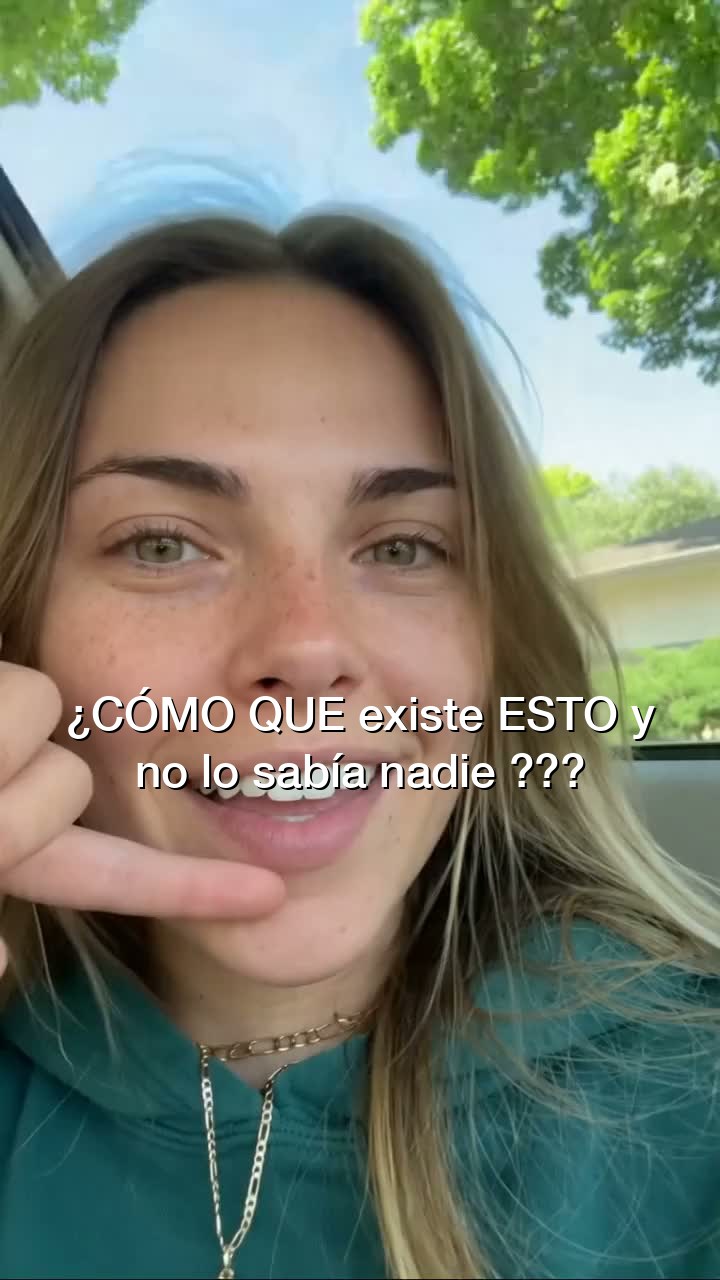 ejemplo · lo escribe él en TikTok
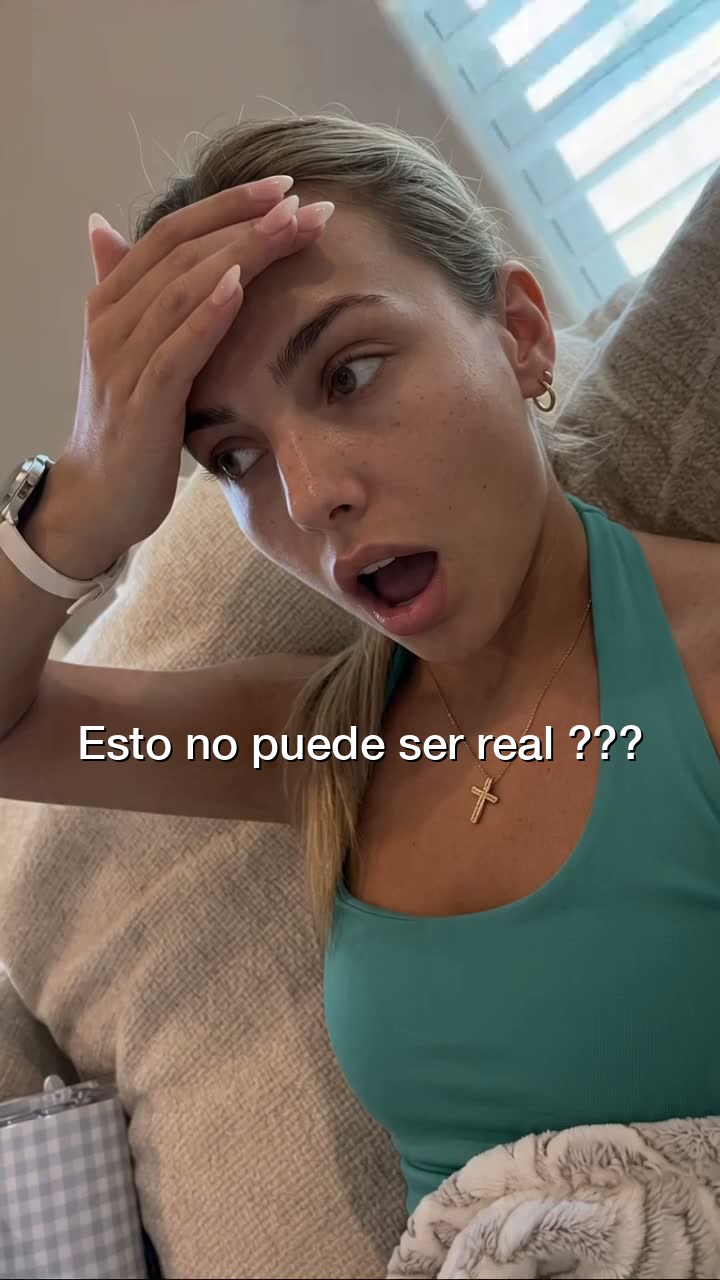 ejemplo · lo escribe él en TikTok
Dos llamadas idénticas a la IA dan resultados distintos, así que cada paso tiene su medida. Todas son aritmética: mismo par de ficheros, mismo número siempre. Ninguna es un modelo que opine.
| # | Dónde | Qué mide | Si falla | Fichero |
|---|---|---|---|---|
| 1 | fotograma generado | geometría: a dónde mira, apertura de ojos, giro de cabeza, boca, manos — todo en IOD | repite la tirada (veto, o 3 avisos a la vez) | qc.py |
| 2 | fotograma generado | contenido: rótulo del original sin borrar, palo o cigarro en la boca, moiré de la tela | repite la tirada | contenido.py |
| 3 | clip animado | fotogramas sin cara, cabeza descolocada, parpadeo, y el control 2 sobre 5 fotogramas | vuelve a animar | filtro_video.py |
| 4 | final del clip | la cola deshecha: los últimos fotogramas rotos | recorta hasta 3 y lo salva; más, repite | video_qc.py |
| 5 | pieza ya montada | 1080×1920 · 30 fps · yuv420p, duración 8-20 s, que haya audio, que no arranque en negro y que el corte al b-roll se vea en el s 3 | sale con código 1: no se entrega | revisa.py |
.task de MediaPipe, que no están
en la carpeta: se bajan una vez (~12 MB) con los comandos de abajo. Sin ellos, los filtros no arrancan.Los seis bloques de abajo son todo lo que necesita: el contexto con las trampas, los cuatro ficheros enteros y los comandos en orden. Cada uno con su botón de copiar.
CONTEXTO — cadena "vídeo IA + b-roll", Canal Reposters (RunnerPro). 16-sep-2026.
Pégalo entero al empezar. Está escrito para ejecutarlo, no para leerlo.

QUÉ SE FABRICA
Una pieza = [gesto de cara hecho con IA, ~3 s] + [b-roll de producto, el resto] concatenados en un MP4
vertical 1080x1920, tope 18 s. La frase-gancho NO se quema en el vídeo: se entrega aparte para que el
operador la escriba con la herramienta de texto de TikTok (rinde mejor que un rótulo quemado).

1) EL VÍDEO IA (el gesto)
[RESERVADO] El detalle de esta parte —proveedor, endpoints, precios, clave de API y los umbrales exactos
de los dos filtros de control— no se publica. Está en la versión interna del vault; pídesela a Cristóbal.
Lo único que hace falta saber aquí: de esa parte sale un MP4 vertical de ~3 s, 720x1280, con el gesto del
vídeo de referencia y una cara que no es de nadie real. Ese fichero es la entrada de todo lo que sigue.

2) LOS B-ROLLS (el plano de producto)
iCloud Drive, una carpeta por funcionalidad:
  /Users/cristobal/Library/Mobile Documents/com~apple~CloudDocs/ACTIVE/Reposters/TANDA VIDEOS - BROLLS /
  TRAMPA 1: ese nombre ACABA EN ESPACIO, y las subcarpetas "HOME ", "FUERZA " y "RECORRIDO LARGO " también.
            Un `cd` normal falla. Abre siempre por ruta literal.
  TRAMPA 2: los ficheros están en la nube. `du` da 0B aunque `stat` dé el tamaño real. Antes de tocarlos:
            `brctl download "<fichero>"` y esperar, o ffmpeg lee un fichero vacío sin avisar.
  Estado a 16-sep-2026: ESCÁNER - NUTRI, FUERZA y RECORRIDO LARGO tienen 3 clips cada una (8,6 a 21,4 s,
  1080x1920 a 30 fps). PLAN y HOME están VACÍAS.

3) LAS FRASES
10 frases-gancho con su semántica (AGRAVIO, PAGA X, CÓMOOO, CONDICIONAL, INCREDULIDAD) y, por cada una,
qué carpeta admite: obligatorio / admitido / vetado. Está en matriz.json, que es la tabla en datos.

EL REPARTO (cruce.py)
 - Las frases se reparten por turnos entre los vídeos IA (12 vídeos y 10 frases -> dos frases repiten).
 - Dentro de una frase, carpeta y clip se eligen por EL MENOS USADO hasta ese momento: los 3 clips de una
   carpeta salen el mismo número de veces. Eso es lo que se pidió: variedad proporcional.
 - "obligatorio" manda mientras no haya salido en la mitad de los vídeos de esa frase.
 - "vetado" no se combina NUNCA, ni aunque no quede otra. Si una frase se queda sin carpeta disponible, la
   pieza se marca pendiente en vez de montarse mal.
 - Hoy, con PLAN y HOME vacías, 5 frases se montan solo con RECORRIDO. Al llenar esas carpetas no se toca
   código: se relanza cruce.py y el reparto se recalcula.

LOS CINCO CONTROLES, EN ORDEN
Nada se da por bueno mirándolo: cada paso tiene su medida, y todas son aritmética pura (mismo par de
ficheros -> mismo número siempre). Ninguno usa un modelo que opine.
  1. qc.py            sobre el fotograma 0 generado. Geometría: a dónde mira, apertura de ojos, giro de
                      cabeza, forma de la boca, dónde están las manos, todo en IOD. Veto -> se repite la
                      tirada. 3 avisos a la vez también repiten.
  2. contenido.py     sobre el mismo fotograma. Lo que qc.py no ve porque solo mide posiciones: rótulo del
                      original que no se borró, palo/cigarro en la boca, moiré de la tela.
  3. filtro_video.py  sobre el clip ya animado: fotogramas sin cara, cabeza descolocada respecto al clip
                      de referencia, parpadeo (cuánto hierve de un fotograma al siguiente) y los mismos
                      controles de contenido sobre 5 fotogramas repartidos.
  4. video_qc.py      la cola: si los últimos fotogramas salen deshechos se recortan (hasta 3) y el clip
                      se salva; más que eso, se repite.
  5. revisa.py        ya en tanda-brolls, sobre la pieza montada: 1080x1920 / 30 fps / yuv420p, duración
                      entre 8 y 20 s, que haya audio, que el primer fotograma no sea negro (el fallo
                      típico del concat) y que en el segundo 3 se vea de verdad el corte al b-roll.
                      Devuelve 1 si algo falla, así que encadena: `python3 revisa.py salida/ && open salida/`.
  Los tres primeros necesitan MediaPipe y sus dos modelos .task, que NO están en la carpeta: se bajan una
  vez de storage.googleapis.com (están los comandos abajo) a la-carpeta-de-la-cara/modelos/.

EL MONTAJE (monta.py)
Gesto IA delante (sus ~3 s enteros) + b-roll detrás hasta 18 s totales. Antes de concatenar se normaliza
TODO —escala a 1080x1920 recortando, 30 fps, SAR 1, audio AAC 48k estéreo— o el corte da un salto. Si una
de las dos fuentes no trae audio se le mete anullsrc, o el concat de audio revienta.

LA ENTREGA
Por pieza: el MP4 limpio, el texto de la frase para copiar, y un fotograma de ejemplo (el fotograma 0 del
gesto con la frase pintada donde va). Estilo del rótulo, medido en el corpus de virales: centrado, blanco,
sin caja, Helvetica Neue Medium (índice 10 de HelveticaNeue.ttc; el 2 es Italic). Centro-alto rinde 2,4x
peor y la caja de color casi 3x peor.

DÓNDE ESTÁ TODO
 ~/projects/codigo/tanda-brolls/   matriz.json · brolls.json · cruce.py · monta.py · ejemplo_rotulo.py
   entrada_ia/  los MP4 de IA        salida/  las piezas montadas
 Vault: 1-Proyectos/MARKETING/CANAL_REPOSTERS/CADENA_TANDA_BROLLS/

REGLAS DE LA CASA
 - Los entregables (HTML, informes) van a la carpeta del canal del que tratan, dentro del vault de Obsidian.
   Nunca a la raíz, nunca dejar el resultado final en /tmp.
 - Los scripts .py NO van dentro del vault: van a ~/projects/codigo/.
 - Nombres de entregable en MAYÚSCULAS_CON_GUIONES_BAJOS.html
{
  "carpetas": ["PLAN", "HOME", "ESCANER", "FUERZA", "RECORRIDO"],
  "rutas": {
    "PLAN":      "PLAN",
    "HOME":      "HOME ",
    "ESCANER":   "ESCÁNER - NUTRI",
    "FUERZA":    "FUERZA ",
    "RECORRIDO": "RECORRIDO LARGO "
  },
  "base": "/Users/cristobal/Library/Mobile Documents/com~apple~CloudDocs/ACTIVE/Reposters/TANDA VIDEOS - BROLLS ",
  "frases": [
    {"id": "f01", "semantica": "AGRAVIO",      "texto": "4 años yendo al gimnasio y AHORA me entero de ESTO ???",              "broll": {"PLAN": "-", "HOME": "si", "ESCANER": "-",  "FUERZA": "obl", "RECORRIDO": "si"}},
    {"id": "f02", "semantica": "AGRAVIO",      "texto": "2 años corriendo y NADIE me había dicho ESTO ??!",                   "broll": {"PLAN": "obl", "HOME": "si", "ESCANER": "-", "FUERZA": "-",   "RECORRIDO": "si"}},
    {"id": "f03", "semantica": "AGRAVIO",      "texto": "3 años intentando ponerme en forma y NADIE me había dicho ESTO ??!", "broll": {"PLAN": "si", "HOME": "si", "ESCANER": "si", "FUERZA": "si", "RECORRIDO": "si"}},
    {"id": "f04", "semantica": "PAGA X",       "texto": "¿CÓMO que la gente paga Strava TODOS LOS MESES si existe ESTO ?!?",  "broll": {"PLAN": "obl", "HOME": "si", "ESCANER": "-", "FUERZA": "-",   "RECORRIDO": "si"}},
    {"id": "f05", "semantica": "CÓMOOO",       "texto": "CÓMOOOO no conocía esto >>",                                         "broll": {"PLAN": "si", "HOME": "si", "ESCANER": "si", "FUERZA": "si", "RECORRIDO": "si"}},
    {"id": "f06", "semantica": "CÓMOOO",       "texto": "CÓMOOOO no conocía esto siendo runner >>",                           "broll": {"PLAN": "obl", "HOME": "si", "ESCANER": "-", "FUERZA": "-",   "RECORRIDO": "si"}},
    {"id": "f07", "semantica": "CONDICIONAL",  "texto": "Si corres y no sigues ningún plan, TIENES que ver ESTO 🤯",           "broll": {"PLAN": "obl", "HOME": "si", "ESCANER": "-", "FUERZA": "-",   "RECORRIDO": "si"}},
    {"id": "f08", "semantica": "CONDICIONAL",  "texto": "Si quieres empezar a correr, TIENES que ver ESTO",                   "broll": {"PLAN": "obl", "HOME": "si", "ESCANER": "-", "FUERZA": "-",   "RECORRIDO": "si"}},
    {"id": "f09", "semantica": "INCREDULIDAD", "texto": "¿CÓMO QUE existe ESTO y no lo sabía nadie ???",                      "broll": {"PLAN": "si", "HOME": "si", "ESCANER": "si", "FUERZA": "si", "RECORRIDO": "si"}},
    {"id": "f10", "semantica": "INCREDULIDAD", "texto": "Esto no puede ser real ???",                                         "broll": {"PLAN": "si", "HOME": "si", "ESCANER": "si", "FUERZA": "si", "RECORRIDO": "si"}}
  ]
}
#!/usr/bin/env python3
"""Cruza los vídeos IA con los b-rolls de las carpetas según la tabla de frases.

Regla de la tabla:  obl = tiene que salir en la mitad de los vídeos de esa frase
                    si  = admitido
                    -   = vetado, no se combina nunca
Reparto: las frases se reparten por turnos entre los vídeos IA, y dentro de cada
frase la carpeta y el clip se eligen por el menos usado hasta ahora (proporcional).
"""
import json, os, sys, collections, pathlib

RAIZ = pathlib.Path(__file__).parent
M = json.load(open(RAIZ / "matriz.json"))
VIDEO_EXT = {".mp4", ".mov", ".m4v", ".webm"}


def clips_por_carpeta():
    out = {}
    for nombre, sub in M["rutas"].items():
        d = pathlib.Path(M["base"]) / sub
        if not d.is_dir():
            out[nombre] = []
            continue
        out[nombre] = sorted(
            str(p) for p in d.iterdir()
            if p.suffix.lower() in VIDEO_EXT and not p.name.startswith(".")
        )
    return out


def videos_ia(carpeta):
    d = pathlib.Path(carpeta)
    return sorted(
        str(p) for p in d.iterdir()
        if p.suffix.lower() in VIDEO_EXT and not p.name.startswith(".")
    )


def reparte(ias, clips):
    frases = M["frases"]
    uso_carpeta = collections.Counter()
    uso_clip = collections.Counter()
    obl_puestos = collections.Counter()   # cuántas veces se ha cumplido el obligatorio por frase
    veces_frase = collections.Counter()
    plan = []

    for i, ia in enumerate(ias):
        fr = frases[i % len(frases)]
        veces_frase[fr["id"]] += 1

        permitidas = [c for c, v in fr["broll"].items() if v in ("si", "obl") and clips.get(c)]
        vetadas    = [c for c, v in fr["broll"].items() if v == "-"]
        faltan     = [c for c, v in fr["broll"].items() if v in ("si", "obl") and not clips.get(c)]
        obligas    = [c for c, v in fr["broll"].items() if v == "obl" and clips.get(c)]

        if not permitidas:
            plan.append({"ia": ia, "frase": fr, "carpeta": None, "clip": None,
                         "motivo": "sin b-roll disponible (vetadas: %s | vacías: %s)"
                                   % (",".join(vetadas), ",".join(faltan))})
            continue

        # el obligatorio manda mientras no llegue a la mitad de los vídeos de esa frase
        candidatas = permitidas
        if obligas and obl_puestos[fr["id"]] * 2 < veces_frase[fr["id"]]:
            candidatas = obligas

        carpeta = min(candidatas, key=lambda c: (uso_carpeta[c], c))
        uso_carpeta[carpeta] += 1
        if fr["broll"][carpeta] == "obl":
            obl_puestos[fr["id"]] += 1

        clip = min(clips[carpeta], key=lambda p: (uso_clip[p], p))
        uso_clip[clip] += 1

        plan.append({"ia": ia, "frase": fr, "carpeta": carpeta, "clip": clip,
                     "vetadas": vetadas, "vacias": faltan})
    return plan, uso_carpeta, uso_clip


if __name__ == "__main__":
    carpeta_ia = sys.argv[1] if len(sys.argv) > 1 else str(RAIZ / "entrada_ia")
    clips = clips_por_carpeta()
    ias = videos_ia(carpeta_ia)

    print("B-ROLLS POR CARPETA")
    for c, l in clips.items():
        print(f"  {c:<10} {len(l):>2} clip(s)" + ("   ← VACÍA" if not l else ""))
    print(f"\nVÍDEOS IA en {carpeta_ia}: {len(ias)}")
    if not ias:
        print("  (mete ahí los MP4 de IA y vuelve a lanzar)")
        sys.exit(0)

    plan, uc, ucl = reparte(ias, clips)
    print("\nREPARTO")
    for p in plan:
        base = os.path.basename(p["ia"])
        if not p["carpeta"]:
            print(f"  {base:<28} {p['frase']['id']}  ⚠️  {p['motivo']}")
        else:
            print(f"  {base:<28} {p['frase']['id']}  {p['carpeta']:<10} {os.path.basename(p['clip'])}")
    print("\nUSO DE CARPETAS:", dict(uc))
    print("USO DE CLIPS:")
    for k, v in sorted(ucl.items()):
        print(f"  {v}×  {os.path.basename(k)}")

    json.dump([{**p, "frase": p["frase"]} for p in plan],
              open(RAIZ / "plan.json", "w"), ensure_ascii=False, indent=2)
    print("\n→ plan.json")
#!/usr/bin/env python3
"""Monta vídeo IA (recortado al gesto) + b-roll de la carpeta que manda la tabla.

  python3 monta.py [carpeta_ia] [--gesto 3.0] [--tope 18] [--solo f01]

Todo se normaliza a 1080x1920 · 30 fps · AAC 48k para que el concat no dé saltos.
"""
import json, os, subprocess, sys, pathlib, unicodedata, re
import cruce

RAIZ = pathlib.Path(__file__).parent
SAL = RAIZ / "salida"
SAL.mkdir(exist_ok=True)

GESTO = 3.0     # segundos de vídeo IA que se quedan (mediana medida del corte: 2,9 s)
TOPE = 18.0     # duración total máxima del montaje


def arg(nombre, defecto):
    if nombre in sys.argv:
        return float(sys.argv[sys.argv.index(nombre) + 1])
    return defecto


def dur(path):
    out = subprocess.run(["ffprobe", "-v", "error", "-show_entries", "format=duration",
                          "-of", "csv=p=0", path], capture_output=True, text=True).stdout.strip()
    return float(out) if out else 0.0


def slug(t):
    t = unicodedata.normalize("NFKD", t).encode("ascii", "ignore").decode()
    return re.sub(r"[^A-Za-z0-9]+", "_", t).strip("_")[:40].upper()


def tiene_audio(path):
    out = subprocess.run(["ffprobe", "-v", "error", "-select_streams", "a",
                          "-show_entries", "stream=index", "-of", "csv=p=0", path],
                         capture_output=True, text=True).stdout.strip()
    return bool(out)


def monta(ia, broll, destino, gesto, tope):
    d_ia = min(dur(ia), gesto)
    d_br = min(dur(broll), max(tope - d_ia, 3.0))

    entradas = ["-i", ia, "-i", broll]
    a_ia, a_br = tiene_audio(ia), tiene_audio(broll)
    idx_mudo = 2
    if not (a_ia and a_br):
        entradas += ["-f", "lavfi", "-t", str(round(max(d_ia, d_br) + 1, 2)), "-i",
                     "anullsrc=channel_layout=stereo:sample_rate=48000"]

    VN = ("[{i}:v]trim=0:{d},setpts=PTS-STARTPTS,"
          "scale=1080:1920:force_original_aspect_ratio=increase,crop=1080:1920,"
          "fps=30,setsar=1[v{n}];")
    AN = ("[{i}:a]atrim=0:{d},asetpts=PTS-STARTPTS,"
          "aformat=sample_rates=48000:channel_layouts=stereo[a{n}];")

    f  = VN.format(i=0, d=round(d_ia, 3), n=0)
    f += VN.format(i=1, d=round(d_br, 3), n=1)
    f += AN.format(i=0 if a_ia else idx_mudo, d=round(d_ia, 3), n=0)
    f += AN.format(i=1 if a_br else idx_mudo, d=round(d_br, 3), n=1)
    f += "[v0][a0][v1][a1]concat=n=2:v=1:a=1[v][a]"

    cmd = (["ffmpeg", "-y", "-v", "error"] + entradas +
           ["-filter_complex", f, "-map", "[v]", "-map", "[a]",
            "-c:v", "libx264", "-preset", "medium", "-crf", "20", "-pix_fmt", "yuv420p",
            "-c:a", "aac", "-b:a", "128k", "-movflags", "+faststart", destino])
    r = subprocess.run(cmd, capture_output=True, text=True)
    if r.returncode != 0:
        return False, r.stderr.strip()[:300]
    return True, round(d_ia + d_br, 2)


if __name__ == "__main__":
    carpeta_ia = sys.argv[1] if len(sys.argv) > 1 and not sys.argv[1].startswith("--") else str(RAIZ / "entrada_ia")
    gesto, tope = arg("--gesto", GESTO), arg("--tope", TOPE)

    clips = cruce.clips_por_carpeta()
    ias = cruce.videos_ia(carpeta_ia)
    if not ias:
        sys.exit("No hay vídeos IA en " + carpeta_ia)
    plan, uc, ucl = cruce.reparte(ias, clips)

    salida = []
    for i, p in enumerate(plan, 1):
        fr = p["frase"]
        if not p["carpeta"]:
            print(f"  {i:02d}  ⚠️  {fr['id']} sin b-roll: {p['motivo']}")
            salida.append({**p, "frase": fr, "archivo": None, "duracion": None})
            continue
        nombre = f"{i:02d}_{fr['id']}_{p['carpeta']}_{slug(fr['texto'])}.mp4"
        ok, info = monta(p["ia"], p["clip"], str(SAL / nombre), gesto, tope)
        print(f"  {i:02d}  {'✅' if ok else '❌'}  {nombre}  {info}")
        salida.append({**p, "frase": fr, "archivo": nombre if ok else None,
                       "duracion": info if ok else None, "error": None if ok else info})

    json.dump(salida, open(RAIZ / "plan.json", "w"), ensure_ascii=False, indent=2)
    print("\n→ salida/ y plan.json")
#!/usr/bin/env python3
"""Fotograma de ejemplo para el operador: fotograma 0 del gesto IA + la frase encima.

No se entrega quemado: es la referencia de DÓNDE va el texto que él escribe en TikTok.
Estilo medido en reference_corpus_rotulo_virales: sin caja, blanco, centro,
Helvetica Neue Medium. El rótulo real lo pone el operador con el texto nativo.
"""
import subprocess, sys, pathlib
from PIL import Image, ImageDraw, ImageFont

FUENTE = "/System/Library/Fonts/HelveticaNeue.ttc"
IDX_MEDIUM = 10


def frame0(video, destino):
    subprocess.run(["ffmpeg", "-y", "-v", "error", "-i", str(video),
                    "-vf", "select=eq(n\\,0)", "-vframes", "1", str(destino)], check=True)
    return destino


def parte(texto, draw, fuente, ancho_max):
    lineas, actual = [], ""
    for p in texto.split():
        prueba = (actual + " " + p).strip()
        if draw.textlength(prueba, font=fuente) <= ancho_max or not actual:
            actual = prueba
        else:
            lineas.append(actual); actual = p
    if actual:
        lineas.append(actual)
    return lineas


def pinta(src, texto, destino, tam=None):
    img = Image.open(src).convert("RGB")
    W, H = img.size
    tam = tam or int(W * 0.064)          # 46 px sobre 720 de ancho
    d = ImageDraw.Draw(img, "RGBA")
    f = ImageFont.truetype(FUENTE, tam, index=IDX_MEDIUM)
    lineas = parte(texto, d, f, W * 0.86)
    if len(lineas) > 3:                   # si no cabe en 3, se baja el cuerpo
        tam = int(tam * 0.82)
        f = ImageFont.truetype(FUENTE, tam, index=IDX_MEDIUM)
        lineas = parte(texto, d, f, W * 0.86)
    alto = len(lineas) * int(tam * 1.26)
    y0 = int(H * 0.58) - alto // 2        # centro de la pantalla, como los virales
    for i, l in enumerate(lineas):
        y = y0 + i * int(tam * 1.26)
        x = (W - d.textlength(l, font=f)) / 2
        d.text((x + 2, y + 2), l, font=f, fill=(0, 0, 0, 120))
        d.text((x, y), l, font=f, fill=(255, 255, 255, 255))
    img.save(destino, quality=88)
    return destino


if __name__ == "__main__":
    pinta(sys.argv[1], sys.argv[2], sys.argv[3])
    print("OK", sys.argv[3])
#!/usr/bin/env python3
"""Revisa las piezas ya montadas antes de dárselas a nadie.

  python3 revisa.py [carpeta]        (por defecto: salida/)

No opina: mide. Cinco cosas que sí rompen una pieza en TikTok —

  1. formato      1080x1920, 30 fps, yuv420p, con faststart (si no, tarda en arrancar)
  2. duración     entre 8 y 20 s, y el corte del gesto donde toca (~3 s)
  3. audio        que exista y no esté mudo del todo (TikTok baja el alcance de los mudos)
  4. arranque     que el primer fotograma no sea negro: es el fallo típico del concat
  5. corte        que en el segundo 3 haya cambio de escena de verdad (el b-roll entró)
"""
import json, pathlib, re, subprocess, sys

RAIZ = pathlib.Path(__file__).parent
DUR_MIN, DUR_MAX = 8.0, 20.0
GESTO_ESPERADO = 3.0
NEGRO_MAX = 18.0      # luma media del primer fotograma
CORTE_MIN = 0.25      # diferencia de escena en el punto de corte


def ffprobe(args):
    return subprocess.run(["ffprobe", "-v", "error"] + args, capture_output=True, text=True).stdout.strip()


def _metadatos(cmd):
    """metadata=print escribe a nivel info: sin -v info no sale nada."""
    return subprocess.run(cmd, capture_output=True, text=True).stderr


def luma(video, t):
    out = _metadatos(["ffmpeg", "-v", "info", "-ss", str(t), "-i", str(video), "-vframes", "1",
                      "-vf", "signalstats,metadata=print:key=lavfi.signalstats.YAVG", "-f", "null", "-"])
    for l in out.splitlines():
        if "YAVG" in l:
            return float(l.split("=")[-1])
    return None


def escena(video, t, ventana=0.7):
    """Pico de cambio de imagen alrededor del segundo t (0 = nada cambia, 1 = otro plano)."""
    out = _metadatos(["ffmpeg", "-v", "info", "-i", str(video),
                      "-vf", "select='gt(scene,0.05)',metadata=print", "-f", "null", "-"])
    pares, ahora = [], None
    for l in out.splitlines():
        m = re.search(r"pts_time:([0-9.]+)", l)
        if m:
            ahora = float(m.group(1))
        elif "scene_score=" in l and ahora is not None:
            pares.append((ahora, float(l.split("=")[-1])))
    cerca = [v for ts, v in pares if abs(ts - t) <= ventana]
    return max(cerca) if cerca else 0.0


def revisa(video):
    fallos, avisos = [], []
    meta = json.loads(ffprobe(["-select_streams", "v:0", "-show_entries",
                               "stream=width,height,r_frame_rate,pix_fmt", "-of", "json", str(video)]) or '{"streams":[{}]}')
    st = (meta.get("streams") or [{}])[0]
    ancho, alto = str(st.get("width", "?")), str(st.get("height", "?"))
    fps, pix = st.get("r_frame_rate", "?"), st.get("pix_fmt", "?")
    dur = float(ffprobe(["-show_entries", "format=duration", "-of", "csv=p=0", str(video)]) or 0)
    audio = ffprobe(["-select_streams", "a:0", "-show_entries", "stream=codec_name", "-of", "csv=p=0", str(video)])

    if (ancho, alto) != ("1080", "1920"):
        fallos.append(f"no es 1080x1920 ({ancho}x{alto})")
    if fps not in ("30/1", "30000/1001"):
        avisos.append(f"fps raro ({fps})")
    if pix != "yuv420p":
        fallos.append(f"pix_fmt {pix} — hay reproductores que no lo abren")
    if not (DUR_MIN <= dur <= DUR_MAX):
        fallos.append(f"dura {dur:.1f} s, fuera de {DUR_MIN}-{DUR_MAX}")
    if not audio:
        fallos.append("sin pista de audio")

    y0 = luma(video, 0)
    if y0 is not None and y0 < NEGRO_MAX:
        fallos.append(f"arranca en negro (luma {y0:.1f})")

    sc = escena(video, GESTO_ESPERADO)
    if sc < CORTE_MIN:
        avisos.append(f"no se ve el corte al b-roll en el s {GESTO_ESPERADO:g} (escena {sc:.2f})")

    return {"archivo": video.name, "dur": round(dur, 2), "res": f"{ancho}x{alto}",
            "audio": audio or "—", "luma0": round(y0, 1) if y0 else None, "corte": round(sc, 2),
            "fallos": fallos, "avisos": avisos}


if __name__ == "__main__":
    carpeta = pathlib.Path(sys.argv[1]) if len(sys.argv) > 1 else RAIZ / "salida"
    videos = sorted(p for p in carpeta.iterdir() if p.suffix.lower() == ".mp4")
    if not videos:
        sys.exit("No hay MP4 en " + str(carpeta))
    informe, malas = [], 0
    for v in videos:
        r = revisa(v)
        informe.append(r)
        if r["fallos"]:
            malas += 1
            print(f"  ❌ {r['archivo']}")
            for f in r["fallos"]:
                print(f"       {f}")
        elif r["avisos"]:
            print(f"  ⚠️  {r['archivo']}  ·  {'; '.join(r['avisos'])}")
        else:
            print(f"  ✅ {r['archivo']}  {r['dur']} s · {r['res']} · corte {r['corte']}")
    json.dump(informe, open(RAIZ / "revision.json", "w"), ensure_ascii=False, indent=2)
    print(f"\n{len(videos)} piezas · {malas} con fallo → revision.json")
    sys.exit(1 if malas else 0)
"""El filtro del fotograma 0: decide si una imagen generada sirve para animar
o hay que volver a tirar.

Lo que lo justifica: v8.1 del gesto 1. Misma llamada que v8 -- mismo prompt,
mismas imagenes -- y salio con la mirada menos girada y la cabeza 4 grados
torcida respecto al original. Como el video lo genera el modelo de vídeo
a partir de ESE fotograma, lo que se tuerza ahi se arrastra los 5 segundos.

No mide "se parece a la original": eso seria justo lo contrario del encargo.
Mide LO QUE TIENE QUE SEGUIR SIENDO IDENTICO cuando cambias de persona:
a donde mira, cuanto abre los ojos, como tiene puesta la cabeza, la forma de
la boca y donde estan las manos. La cara, el pelo y el color de la ropa
pueden cambiar -- de hecho deben.

Todo en unidades IOD (la distancia entre los centros de los ojos), asi no
depende de la resolucion ni de lo cerca que este la camara. Los fotogramas
salen a 720x1280 y el modelo devuelve 768x1365: medir en pixeles daria error.
"""
import math, pathlib, statistics, threading
import numpy as np
from PIL import Image, ImageChops
import mediapipe as mp
from mediapipe.tasks import python as mp_python
from mediapipe.tasks.python import vision

MOD = pathlib.Path(__file__).parent / "modelos"

OJO = {  # (rabillo externo, rabillo interno, parpado sup, parpado inf, centro del iris)
    "izq": (33, 133, 159, 145, 468),
    "der": (263, 362, 386, 374, 473),
}
NARIZ, MENTON = 1, 152
BOCA_IZQ, BOCA_DER, LABIO_SUP, LABIO_INF = 61, 291, 13, 14

# --- umbrales -------------------------------------------------------------
# v1, calibrados sobre los 9 pares que ya teniamos (tanda3, v8 y v8.1 de los
# tres gestos). No son sagrados: son el punto donde el fallo que vimos con los
# ojos queda fuera y lo que dimos por bueno queda dentro.
# Dos niveles, porque un solo umbral no valia: puesto donde caza el fallo de
# v8.1 tumbaba tambien lo que ya habiamos dado por bueno. AVISO = se anota;
# VETO = se repite la tirada. Y una tirada con 3 avisos se repite igual: el
# fallo de v8.1 no fue una medida disparada, fueron cuatro a la vez.
UMBRALES = {   # medida: (aviso, veto, que mide)
    "mirada izq":      (0.045, 0.080, "ancho de ojo — a donde mira"),
    "mirada der":      (0.045, 0.080, "ancho de ojo — a donde mira"),
    "parpado izq":     (0.100, 0.160, "cuanto abre el ojo"),
    "parpado der":     (0.100, 0.160, "cuanto abre el ojo"),
    "giro cabeza":     (1.500, 3.000, "grados — inclinacion de la linea de los ojos"),
    "cabeza izqda":    (0.100, 0.180, "IOD — cuanto gira la cara a un lado"),
    "cabeza arriba":   (0.200, 0.280, "IOD — cuanto levanta o baja la barbilla"),
    "tamano cabeza":   (0.080, 0.150, "fraccion — cuanto ocupa la cabeza en el encuadre"),
    "posicion cabeza": (0.060, 0.120, "IOD — donde esta la cabeza en el cuadro"),
    "boca abierta":    (0.100, 0.200, "IOD — separacion entre labios"),
    "boca ancho":      (0.100, 0.180, "IOD — de comisura a comisura"),
    "manos":           (0.250, 0.450, "IOD — mediana de los 21 puntos de la mano"),
    "manos (pixel)":   (18.00, 30.00, "diferencia media de pixel en la caja de la mano"),
}
AVISOS_QUE_VETAN = 3

_local = threading.local()
def _facer():
    _fd = getattr(_local, "cara", None)
    if _fd is None:
        _fd = _local.cara = vision.FaceLandmarker.create_from_options(vision.FaceLandmarkerOptions(
            base_options=mp_python.BaseOptions(model_asset_path=str(MOD/"face_landmarker.task"),
                                               delegate=mp_python.BaseOptions.Delegate.CPU),
            running_mode=vision.RunningMode.IMAGE, num_faces=1,
            min_face_detection_confidence=0.3))
    return _fd

def _hander():
    _hd = getattr(_local, "mano", None)
    if _hd is None:
        _hd = _local.mano = vision.HandLandmarker.create_from_options(vision.HandLandmarkerOptions(
            base_options=mp_python.BaseOptions(model_asset_path=str(MOD/"hand_landmarker.task"),
                                               delegate=mp_python.BaseOptions.Delegate.CPU),
            running_mode=vision.RunningMode.IMAGE, num_hands=2,
            min_hand_detection_confidence=0.3))
    return _hd

def _mpimg(ruta):
    arr = np.array(Image.open(ruta).convert("RGB"))
    return mp.Image(image_format=mp.ImageFormat.SRGB, data=arr), arr.shape[1], arr.shape[0]

def _cara(ruta):
    img, w, h = _mpimg(ruta)
    r = _facer().detect(img)
    if not r.face_landmarks: return None
    return np.array([[p.x, p.y*h/w] for p in r.face_landmarks[0]])   # fracciones del ANCHO

def _manos(ruta):
    img, w, h = _mpimg(ruta)
    return [np.array([[p.x, p.y*h/w] for p in m]) for m in _hander().detect(img).hand_landmarks]

def _rasgos(p):
    c = {}
    centros = {k: (p[v[0]] + p[v[1]]) / 2 for k, v in OJO.items()}
    iod = float(np.linalg.norm(centros["izq"] - centros["der"])) or 1e-6
    c["_iod"] = iod
    c["_centro"] = (centros["izq"] + centros["der"]) / 2
    for k, (ext, inte, sup, inf, iris) in OJO.items():
        ancho = float(np.linalg.norm(p[ext] - p[inte])) or 1e-6
        centro = (p[ext] + p[inte]) / 2
        c[f"mirada_x_{k}"] = float((p[iris][0] - centro[0]) / ancho)
        c[f"mirada_y_{k}"] = float((p[iris][1] - centro[1]) / ancho)
        c[f"parpado_{k}"] = float(np.linalg.norm(p[sup] - p[inf]) / ancho)
    d = centros["der"] - centros["izq"]
    c["giro"] = math.degrees(math.atan2(d[1], d[0]))
    c["yaw"] = float((p[NARIZ][0] - c["_centro"][0]) / iod)
    c["pitch"] = float((p[MENTON][1] - c["_centro"][1]) / iod)
    c["boca_abierta"] = float(np.linalg.norm(p[LABIO_SUP] - p[LABIO_INF]) / iod)
    c["boca_ancho"] = float(np.linalg.norm(p[BOCA_IZQ] - p[BOCA_DER]) / iod)
    return c

def _caja_pixel(ruta_a, ruta_b, caja):
    """Diferencia media de pixel en una caja (en fracciones del ancho)."""
    ia, ib = Image.open(ruta_a).convert("RGB"), Image.open(ruta_b).convert("RGB")
    ib = ib.resize(ia.size)
    w, h = ia.size
    r = (max(0,int(caja[0]*w)), max(0,int(caja[1]*w)), min(w,int(caja[2]*w)), min(h,int(caja[3]*w)))
    if r[2] <= r[0] or r[3] <= r[1]: return None
    return statistics.mean(ImageChops.difference(ia.crop(r), ib.crop(r)).convert("L").getdata())

def medir(original, generada):
    """Desviaciones de la generada respecto a la original. dict + '_notas'."""
    po, pg = _cara(original), _cara(generada)
    if po is None or pg is None:
        return {"_error": "no se detecta cara en " + ("el original" if po is None else "la generada")}
    a, b = _rasgos(po), _rasgos(pg)
    d, notas = {}, []
    for k in ("izq", "der"):
        d[f"mirada {k}"] = math.hypot(b[f"mirada_x_{k}"]-a[f"mirada_x_{k}"],
                                      b[f"mirada_y_{k}"]-a[f"mirada_y_{k}"])
        d[f"parpado {k}"] = abs(b[f"parpado_{k}"]-a[f"parpado_{k}"])
    d["giro cabeza"] = abs(b["giro"]-a["giro"])
    d["cabeza izqda"] = abs(b["yaw"]-a["yaw"])
    d["cabeza arriba"] = abs(b["pitch"]-a["pitch"])
    d["tamano cabeza"] = abs(b["_iod"]/a["_iod"] - 1)
    d["posicion cabeza"] = float(np.linalg.norm(b["_centro"]-a["_centro"]) / a["_iod"])
    d["boca abierta"] = abs(b["boca_abierta"]-a["boca_abierta"])
    d["boca ancho"] = abs(b["boca_ancho"]-a["boca_ancho"])

    # --- manos -------------------------------------------------------------
    # El detector de manos falla mas que el de cara (una mano medio fuera de
    # cuadro no la ve). Por eso hay dos vias, y la ausencia de mano NUNCA
    # tumba sola una imagen: si no se puede medir, se dice.
    ma, mb = _manos(original), _manos(generada)
    if not ma:
        notas.append("sin manos detectadas en el original: no se comprueban")
    elif len(ma) == len(mb):
        peores = []
        libres = list(mb)
        for h in ma:
            j = min(range(len(libres)), key=lambda i: np.linalg.norm(libres[i].mean(0)-h.mean(0)))
            dist = np.linalg.norm(libres.pop(j)-h, axis=1) / a["_iod"]
            peores.append(float(np.median(dist)))
        d["manos"] = max(peores)
    else:
        # se ve en el original pero no en la generada: se compara a pixel la
        # caja donde estaba la mano, que es lo unico que sabemos seguro
        caja = None
        for h in ma:
            c = (h[:,0].min(), h[:,1].min(), h[:,0].max(), h[:,1].max())
            m = max(c[2]-c[0], c[3]-c[1]) * 0.15
            c = (c[0]-m, c[1]-m, c[2]+m, c[3]+m)
            caja = c if caja is None else (min(caja[0],c[0]), min(caja[1],c[1]),
                                           max(caja[2],c[2]), max(caja[3],c[3]))
        v = _caja_pixel(original, generada, caja)
        if v is not None:
            d["manos (pixel)"] = v
            notas.append(f"manos: {len(ma)} en el original y {len(mb)} en la generada, "
                         f"se compara la caja a pixel")
    d["_notas"] = notas
    return d

def revisar(original, generada):
    """(ok, motivos, medidas). ok=False significa: vuelve a tirar."""
    d = medir(original, generada)
    if "_error" in d:
        return False, [d["_error"]], d
    vetos, avisos = [], []
    for k, v in d.items():
        if k.startswith("_") or k not in UMBRALES: continue
        av, vt, que = UMBRALES[k]
        if v > vt:   vetos.append(f"VETO {k}: {v:.3f} > {vt:g} ({que})")
        elif v > av: avisos.append(f"aviso {k}: {v:.3f} > {av:g} ({que})")
    d["_vetos"], d["_avisos"] = vetos, avisos
    if len(avisos) >= AVISOS_QUE_VETAN:
        vetos = vetos + [f"VETO por acumulacion: {len(avisos)} avisos a la vez"]
    return (not vetos), vetos + avisos, d

def peor_ratio(d):
    """Cuanto se pasa la peor medida, en veces su umbral de VETO."""
    r = [v/UMBRALES[k][1] for k, v in d.items()
         if not k.startswith("_") and k in UMBRALES]
    return max(r) if r else float("inf")

def puntuar(d):
    """Clave de orden para elegir la mejor de varias tiradas. Menor es mejor.

    1o las que pasan, 2o la que tiene la peor medida menos disparada, 3o la
    media de todas. Sin el tercer criterio dos tiradas empatan a menudo.
    """
    if "_error" in d: return (2, float("inf"), float("inf"))
    r = [v/UMBRALES[k][1] for k, v in d.items()
         if not k.startswith("_") and k in UMBRALES]
    if not r: return (2, float("inf"), float("inf"))
    pasa = not d.get("_vetos") and len(d.get("_avisos", [])) < AVISOS_QUE_VETAN
    return (0 if pasa else 1, max(r), sum(r)/len(r))

def limpia(d):
    """Sin un solo aviso. Si sale una asi, no hace falta seguir tirando."""
    return not d.get("_vetos") and not d.get("_avisos")

if __name__ == "__main__":
    T = pathlib.Path(__file__).parent / "tanda"
    filas = []
    for n in ("01","02","03"):
        for v in ("editado","v8","v81"):
            f = T/f"g{n}_{v}.png"
            if not f.exists(): continue
            ok, motivos, d = revisar(T/f"g{n}_frame0.png", f)
            filas.append((f"g{n} {v}", ok, motivos, d))
    claves = [k for k in UMBRALES if any(k in d for *_, d in filas)]
    print("pareja       veredicto " + "".join(f"{k[:12]:>13s}" for k in claves))
    print("aviso                  " + "".join(f"{UMBRALES[k][0]:13.3f}" for k in claves))
    print("veto                   " + "".join(f"{UMBRALES[k][1]:13.3f}" for k in claves))
    for nom, ok, motivos, d in filas:
        print(f"{nom:12s} {'PASA':9s}" if ok else f"{nom:12s} {'REPETIR':9s}", end="")
        print("".join(f"{d[k]:13.3f}" if k in d else f"{'-':>13s}" for k in claves))
    print()
    for nom, ok, motivos, d in filas:
        for m in motivos: print(f"{nom}: {m}")
        for n_ in d.get("_notas", []): print(f"{nom}: ({n_})")
"""El segundo filtro, sin modelos: solo medidas sobre los pixeles.

qc.py mide DONDE esta cada cosa y da por buena una tirada aunque lo que haya en
ese sitio sea otra cosa. Los tres fallos que se colaron:

  - el rotulo del gesto 2 no se borro,
  - el dedo del gesto 3 salio convertido en un CIGARRO,
  - el top azul del gesto 1 salio con el moire de la camara sobre el punto.

Aqui los caza aritmetica, no un juez de vision: mismo par de imagenes, mismo
numero siempre. Cada comprobacion usa el ORIGINAL como patron -- sabemos donde
estaba el rotulo, donde esta la boca y donde esta la ropa -- y mide cuanto se
desvia la generada de lo que deberia haber pasado ahi.
"""
import pathlib
import cv2
import numpy as np

# --- umbrales, calibrados con los 15 pares de la pagina --------------------
UMBRALES = {
    "rotulo restante": (0.25, 0.45, "fraccion del rotulo original que sigue escrita"),
    "objeto en boca":  (1.20, 2.00, "barra clara y alargada asomando de la boca que no estaba"),
    "moire en la ropa":(1.30, 1.50, "veces la textura periodica que tiene la tela del original"),
}

def _leer(ruta, ancho=720, alto=None):
    im = cv2.imread(str(ruta))
    if im is None: raise FileNotFoundError(ruta)
    # el fotograma entra a 720x1280 y el modelo devuelve 768x1365: redondear
    # cada uno por su lado deja un pixel de diferencia y las mascaras no casan
    return cv2.resize(im, (ancho, alto or int(round(im.shape[0]*ancho/im.shape[1]))))

def _gris(im): return cv2.cvtColor(im, cv2.COLOR_BGR2GRAY)

# ---------------------------------------------------------------- 1. ROTULO
def mascara_rotulo(orig_gris):
    """Donde estan las letras del original.

    Un rotulo quemado en un video es texto MUY claro con borde oscuro pegado.
    Eso da dos cosas a la vez que casi nada mas da: pixel casi blanco Y
    gradiente fuerte justo al lado. Se pide las dos y se cierra en horizontal
    para unir las letras de una misma linea.
    """
    claro = orig_gris > 205
    borde = cv2.morphologyEx(cv2.Canny(orig_gris, 80, 200), cv2.MORPH_DILATE,
                             np.ones((5, 5), np.uint8)) > 0
    m = (claro & borde).astype(np.uint8)
    m = cv2.morphologyEx(m, cv2.MORPH_CLOSE, np.ones((3, 15), np.uint8))
    n, etiq, est, _ = cv2.connectedComponentsWithStats(m, 8)
    out = np.zeros_like(m)
    for i in range(1, n):
        x, y, w, h, area = est[i]
        # una linea de rotulo es ancha, baja y con area suficiente; asi se cae
        # el brillo de una ventana o el reflejo de una joya
        if area > 120 and w > 3*h and w > 60 and h < orig_gris.shape[0]*0.10:
            out[etiq == i] = 1
    return out.astype(bool)

def rotulo_restante(orig, gen):
    """0 = borrado y repintado · 1 = sigue entero."""
    go, gg = _gris(orig), _gris(gen)
    m = mascara_rotulo(go)
    if m.sum() < 200:
        return 0.0, m   # el original no llevaba rotulo: nada que borrar
    # el rotulo se ve porque las letras son mucho mas claras que lo de al lado.
    # se mide ese contraste en el original y cuanto queda en la generada.
    fuera = cv2.dilate(m.astype(np.uint8), np.ones((9, 9), np.uint8), 1).astype(bool) & ~m
    def contraste(g):
        return float(g[m].mean() - g[fuera].mean())
    c_o, c_g = contraste(go), contraste(gg)
    return max(0.0, min(1.5, c_g / c_o if c_o > 1 else 0.0)), m

# ------------------------------------------------------------- 2. LA BOCA
def _palo(im, pts):
    """Puntuacion del trozo blanco mas parecido a un palo que hay en la boca.

    Un cigarro, un boli o una pajita son lo mismo para un pixel: una mancha
    clara, POCO saturada, larga, estrecha y maciza. Los dientes tambien son
    claros -- por eso no decide el brillo, decide la FORMA: los dientes salen
    como una mancha ancha (alargamiento ~2-4 y medio vacia), el palo como una
    barra (alargamiento >5 y casi llena).

    puntuacion = alargamiento x cuanto llena su rectangulo.
    """
    h, w = im.shape[:2]
    idx = [61, 291, 13, 14, 0, 17]
    xs, ys = pts[idx, 0]*w, pts[idx, 1]*w
    m = (xs.max()-xs.min())*0.9            # generoso: el palo sale de la boca
    x0, x1 = int(max(0, xs.min()-m)), int(min(w, xs.max()+m))
    y0, y1 = int(max(0, ys.min()-m)), int(min(h, ys.max()+m))
    roi = im[y0:y1, x0:x1]
    if roi.size == 0 or min(roi.shape[:2]) < 30: return 0.0
    esc = 1.0
    hsv = cv2.cvtColor(roi, cv2.COLOR_BGR2HSV)
    S, V = hsv[:, :, 1], hsv[:, :, 2]
    # blanco de PAPEL, no de piel: un dedo palido sigue teniendo tono de piel
    # (saturacion media-alta), un cigarro o una pajita no tienen color ninguno
    mask = ((S < 45) & (V > max(150, np.percentile(V, 85)))).astype(np.uint8)
    mask = cv2.morphologyEx(mask, cv2.MORPH_OPEN, np.ones((3, 3), np.uint8))

    # el contorno de los labios, para distinguir un palo de una fila de dientes:
    # los dientes viven DENTRO de la boca, el palo asoma por fuera
    LABIOS = [61, 146, 91, 181, 84, 17, 314, 405, 321, 375, 291,
              409, 270, 269, 267, 0, 37, 39, 40, 185]
    poly = np.array([[(pts[i, 0]*w - x0)*esc, (pts[i, 1]*w - y0)*esc] for i in LABIOS], np.int32)
    dentro = np.zeros(roi.shape[:2], np.uint8)
    cv2.fillPoly(dentro, [poly], 1)
    dentro = cv2.dilate(dentro, np.ones((5, 5), np.uint8), 1).astype(bool)

    n, etiq, est, _ = cv2.connectedComponentsWithStats(mask, 8)
    area_min = 0.012 * roi.shape[0] * roi.shape[1]
    mejor = 0.0
    for i in range(1, n):
        area = est[i][4]
        if area < area_min: continue
        trozo = etiq == i
        if (trozo & ~dentro).sum() / area < 0.25: continue   # no asoma: son dientes
        pts_i = cv2.findNonZero(trozo.astype(np.uint8))
        (_, _), (rw, rh), _ = cv2.minAreaRect(pts_i)
        largo, corto = max(rw, rh), max(1.0, min(rw, rh))
        relleno = area / max(1.0, rw*rh)
        mejor = max(mejor, (largo/corto) * relleno)
    return mejor

def objeto_en_boca(orig, gen, pts_orig, pts_gen):
    """Cuanto mas palo hay en la boca de la generada que en la del original."""
    return max(0.0, _palo(gen, pts_gen) - _palo(orig, pts_orig))

# ------------------------------------------------------------- 3. EL MOIRE
def _roi_ropa(im, pts):
    h, w = im.shape[:2]
    cx, cy = float(pts[152, 0]*w), float(pts[152, 1]*w)
    iod = float(np.linalg.norm((pts[33]-pts[263])*[w, w]))
    x0, x1 = int(max(0, cx-1.2*iod)), int(min(w, cx+1.2*iod))
    y0, y1 = int(min(h-4, cy+0.6*iod)), int(min(h, cy+2.4*iod))
    if x1-x0 < 40 or y1-y0 < 40: return None
    return cv2.cvtColor(im[y0:y1, x0:x1], cv2.COLOR_BGR2GRAY)

def _periodicidad(g):
    """Cuanto se repite a si misma la textura, por autocorrelacion.

    El moire es un patron REGULAR: rayas o anillos a un paso fijo. Una tela
    normal, no. Si se desplaza el trozo sobre si mismo, la tela con moire
    vuelve a encajar consigo misma a esa distancia y da un segundo pico; la
    lisa se va apagando. Se devuelve la altura de ese segundo pico (0-1).
    """
    g = cv2.resize(g.astype(np.float32), (256, 256))
    g = g - cv2.GaussianBlur(g, (0, 0), 6)          # fuera iluminacion y pliegues
    g *= np.outer(np.hanning(256), np.hanning(256))
    F = np.fft.fft2(g)
    ac = np.fft.fftshift(np.real(np.fft.ifft2(F*np.conj(F))))
    ac /= max(1e-9, ac.max())
    yy, xx = np.mgrid[0:256, 0:256]
    r = np.hypot(yy-128, xx-128)
    # la banda 12-30 es donde cae el paso de un moire o de un canale: mas cerca
    # del centro son los pliegues, mas lejos es el grano del sensor
    return float(ac[(r > 12) & (r < 30)].max())

def moire(orig, gen, pts_orig, pts_gen):
    """Veces que la tela de la generada se repite mas que la del original."""
    a, b = _roi_ropa(orig, pts_orig), _roi_ropa(gen, pts_gen)
    if a is None or b is None: return 1.0
    pa, pb = _periodicidad(a), _periodicidad(b)
    return pb / max(0.02, pa)

# ------------------------------------------------------------------ API
def revisar(original, generada, pts_orig, pts_gen, sin_texto=True):
    """(ok, motivos, medidas). Mismo contrato que qc.revisar."""
    o = _leer(original)
    g = _leer(generada, alto=o.shape[0])
    d = {}
    rot, _ = rotulo_restante(o, g)
    if sin_texto: d["rotulo restante"] = rot
    d["objeto en boca"] = objeto_en_boca(o, g, pts_orig, pts_gen)
    d["moire en la ropa"] = moire(o, g, pts_orig, pts_gen)
    vetos, avisos = [], []
    for k, v in d.items():
        av, vt, que = UMBRALES[k]
        if v > vt:   vetos.append(f"VETO {k}: {v:.2f} > {vt:g} ({que})")
        elif v > av: avisos.append(f"aviso {k}: {v:.2f} > {av:g} ({que})")
    d["_vetos"], d["_avisos"] = vetos, avisos
    return (not vetos), vetos + avisos, d
"""El filtro del video, hermano del de la imagen pero mas permisivo.

Sobre el fotograma 0 se es duro: es barato repetir (lo que cuesta una imagen) y lo que se tuerza
ahi se arrastra los 5 segundos. Un video cuesta 3 veces mas y tarda 3 minutos,
asi que aqui los umbrales se abren: se busca lo que ROMPE el clip, no lo que lo
aparta un poco del original.

Cinco medidas, todas comparando contra el clip del rodaje:

  1. fotogramas sin cara -- el destrozo tipico del modelo de vídeo: la cara se deshace.
  2. cabeza descolocada  -- p95 de lo que se mueve el centro de la cara
                            respecto al clip. Cazaria que la persona derive.
  3. parpadeo            -- cuanto cambia cada fotograma respecto al anterior
                            comparado con el clip: si el generado parpadea o
                            hierve, este numero se dispara.
  4. contenido           -- el filtro de las imagenes sobre 5 fotogramas
                            repartidos, pero comparando cada uno contra EL MISMO
                            fotograma del clip, no contra el fotograma 0: la
                            persona se mueve, asi que comparar un fotograma del
                            medio con una foto quieta da falsos positivos (el
                            moire llegaba a 3,7 por ahi). Se miran el rotulo y
                            el palo en la boca; el moire se mide en el fotograma
                            0 y no cambia a mitad de clip.
  5. cola rota           -- fotogramas rotos SEGUIDOS al final. Hasta 3 no vetan:
                            se recortan (0,19 s) y el clip se salva.
"""
import pathlib
import cv2
import numpy as np
import mediapipe as mp
import contenido, qc

UMBRALES = {
    "fotogramas sin cara": (0.02, 0.08, "fraccion del clip en la que se pierde la cara"),
    "cabeza descolocada":  (0.10, 0.20, "IOD · p95 de lo que se aparta del clip original"),
    "parpadeo":            (1.60, 2.40, "veces lo que cambia de fotograma a fotograma el clip"),
    "contenido":           (0.90, 1.00, "peor medida del filtro de imagen, en veces su veto"),
    "cola rota":           (3.00, 6.00, "fotogramas seguidos rotos al final (hasta 3 se recortan)"),
}
MUESTRAS_CONTENIDO = 5

def _cara(arr):
    img = mp.Image(image_format=mp.ImageFormat.SRGB, data=cv2.cvtColor(arr, cv2.COLOR_BGR2RGB))
    r = qc._facer().detect(img)
    if not r.face_landmarks: return None
    h, w = arr.shape[:2]
    return np.array([[p.x, p.y*h/w] for p in r.face_landmarks[0]])

def _leer(ruta):
    cap = cv2.VideoCapture(str(ruta)); fr = []
    while True:
        ok, f = cap.read()
        if not ok: break
        fr.append(f)
    cap.release(); return fr

def _movimiento(frames):
    """Cuanto cambia el clip de un fotograma al siguiente, de media."""
    if len(frames) < 2: return 0.0
    g = [cv2.cvtColor(cv2.resize(f, (180, 320)), cv2.COLOR_BGR2GRAY).astype(np.float32) for f in frames]
    return float(np.median([np.abs(g[i]-g[i-1]).mean() for i in range(1, len(g))]))

def revisar(generado, driver, frame0_original=None):
    """(ok, motivos, medidas). medidas['_rotos'] lista los fotogramas rotos."""
    G, D = _leer(generado), _leer(driver)
    if not G: return False, ["el video generado no se puede leer"], {}
    d, rotos = {}, []

    caras_g = [_cara(f) for f in G]
    caras_d = [_cara(f) for f in D]
    d["fotogramas sin cara"] = sum(p is None for p in caras_g) / len(G)

    desv = []
    for i, p in enumerate(caras_g):
        if p is None: rotos.append(i); continue
        pd = caras_d[i] if i < len(caras_d) else None
        if pd is None: continue
        iod = float(np.linalg.norm(p[33]-p[263])) or 1e-6
        v = float(np.linalg.norm((p[33]+p[263])/2 - (pd[33]+pd[263])/2) / iod)
        desv.append(v)
        if v > UMBRALES["cabeza descolocada"][1]: rotos.append(i)
    d["cabeza descolocada"] = float(np.percentile(desv, 95)) if desv else 0.0

    mg, md = _movimiento(G), _movimiento(D)
    d["parpadeo"] = mg / max(1e-6, md)

    # contenido: cada fotograma contra EL MISMO fotograma del clip
    peor = 0.0
    idx = np.linspace(0, min(len(G), len(D))-1, MUESTRAS_CONTENIDO).astype(int)
    ta = pathlib.Path(generado).with_suffix(".a.png")
    tb = pathlib.Path(generado).with_suffix(".b.png")
    for i in idx:
        pg, pd = caras_g[i], caras_d[i]
        if pg is None or pd is None: continue
        cv2.imwrite(str(ta), D[i]); cv2.imwrite(str(tb), G[i])
        oi = contenido._leer(ta); gi = contenido._leer(tb, alto=oi.shape[0])
        rot, _ = contenido.rotulo_restante(oi, gi)
        palo = contenido.objeto_en_boca(oi, gi, pd, pg)
        peor = max(peor,
                   rot / contenido.UMBRALES["rotulo restante"][1],
                   palo / contenido.UMBRALES["objeto en boca"][1])
    ta.unlink(missing_ok=True); tb.unlink(missing_ok=True)
    d["contenido"] = peor

    cola = 0
    for k in range(len(G)-1, -1, -1):
        if k in rotos: cola += 1
        else: break
    d["cola rota"] = float(cola)
    d["_rotos"] = sorted(set(rotos)); d["_total"] = len(G)

    vetos, avisos = [], []
    for k, v in d.items():
        if k.startswith("_"): continue
        av, vt, que = UMBRALES[k]
        if v > vt:   vetos.append(f"VETO {k}: {v:.2f} > {vt:g} ({que})")
        elif v > av: avisos.append(f"aviso {k}: {v:.2f} > {av:g} ({que})")
    d["_vetos"], d["_avisos"] = vetos, avisos
    return (not vetos), vetos + avisos, d

def puntuar(d):
    """Clave de orden para elegir el mejor de varios videos. Menor es mejor.

    Igual que en las imagenes: primero los que pasan, y entre ellos el que
    tiene su peor medida menos disparada. Que uno pase no lo hace el mejor.
    """
    if not d: return (2, float("inf"), float("inf"))
    r = [v/UMBRALES[k][1] for k, v in d.items() if not k.startswith("_") and k in UMBRALES]
    if not r: return (2, float("inf"), float("inf"))
    pasa = not d.get("_vetos")
    return (0 if pasa else 1, max(r), sum(r)/len(r))


if __name__ == "__main__":
    B = pathlib.Path(__file__).parent
    print(f"{'gesto':8s}" + "".join(f"{k[:13]:>16s}" for k in UMBRALES) + "   veredicto")
    print(f"{'aviso':8s}" + "".join(f"{UMBRALES[k][0]:16.2f}" for k in UMBRALES))
    print(f"{'veto':8s}" + "".join(f"{UMBRALES[k][1]:16.2f}" for k in UMBRALES))
    for n in ("01", "02", "03"):
        ok, motivos, d = revisar(B/f"v10b_video/g{n}_v10.mp4", B/f"tanda/g{n}_driver.mp4",
                                 B/f"tanda/g{n}_frame0.png")
        print(f"g{n:6s}" + "".join(f"{d[k]:16.2f}" for k in UMBRALES) +
              ("   PASA" if ok else "   REPETIR"))
        for m in motivos: print("        ", m)
        if d.get("_rotos"): print(f"         fotogramas rotos: {d['_rotos']} de {d['_total']}")
"""El ultimo filtro: la cola del video.

el modelo de vídeo copia el movimiento del clip fotograma a fotograma y casi
siempre aguanta -- pero en el gesto 3 los ultimos fotogramas salieron
emborronados, con la mano deshaciendose sobre la cara, y el modelo hasta se
invento una barra de iOS que no esta ni en el clip ni en el fotograma 0.

Se caza sin mirar: si en un fotograma generado NO se detecta cara, o la cabeza
esta en un sitio muy distinto que en el clip original, ese fotograma esta roto.
Como el destrozo siempre pasa al final, se recorta la cola y listo: 2 de 48
fotogramas son 0,12 s que nadie echa de menos.

Solo recorta por el FINAL. Un fotograma malo en medio no se puede quitar sin
romper el movimiento: eso se marca y se vuelve a animar.
"""
import pathlib, subprocess
import cv2
import numpy as np
import mediapipe as mp
import qc

DESVIACION_MAX = 0.12   # IOD: cuanto puede moverse el centro de la cara respecto al clip

def _cara(arr):
    img = mp.Image(image_format=mp.ImageFormat.SRGB, data=cv2.cvtColor(arr, cv2.COLOR_BGR2RGB))
    r = qc._facer().detect(img)
    if not r.face_landmarks: return None
    h, w = arr.shape[:2]
    return np.array([[p.x, p.y*h/w] for p in r.face_landmarks[0]])

def revisar(generado, driver):
    """(ok, rotos, total). rotos = indices de fotogramas sin cara o descolocados."""
    a, b = cv2.VideoCapture(str(generado)), cv2.VideoCapture(str(driver))
    rotos, i = [], 0
    while True:
        ok, f = a.read()
        okd, fd = b.read()
        if not ok: break
        p = _cara(f)
        if p is None:
            rotos.append(i)
        elif okd:
            pd = _cara(fd)
            if pd is not None:
                iod = float(np.linalg.norm(p[33]-p[263])) or 1e-6
                if float(np.linalg.norm((p[33]+p[263])/2 - (pd[33]+pd[263])/2) / iod) > DESVIACION_MAX:
                    rotos.append(i)
        i += 1
    a.release(); b.release()
    return (not rotos), rotos, i

def recortar_cola(entrada, salida, rotos, total, fps=16):
    """Corta los fotogramas rotos del final. Devuelve cuantos ha quitado."""
    if not rotos: return 0
    cola = 0
    for k in range(total-1, -1, -1):        # cuantos rotos SEGUIDOS hay al final
        if k in rotos: cola += 1
        else: break
    if cola == 0:                            # los rotos estan en medio: no se recorta
        return -len(rotos)
    subprocess.run(["ffmpeg", "-y", "-loglevel", "error", "-i", str(entrada),
                    "-frames:v", str(total-cola), "-c:v", "libx264", "-pix_fmt", "yuv420p",
                    "-r", str(fps), str(salida)], check=True)
    return cola

if __name__ == "__main__":
    B = pathlib.Path(__file__).parent
    for n in ("01", "02", "03"):
        gen, drv = B/f"v10b_video/g{n}_v10.mp4", B/f"tanda/g{n}_driver.mp4"
        ok, rotos, total = revisar(gen, drv)
        if ok:
            print(f"g{n}: {total} fotogramas, todos buenos")
            continue
        cortados = recortar_cola(gen, B/f"v10b_video/g{n}_v10_limpio.mp4", rotos, total)
        if cortados > 0:
            print(f"g{n}: rotos {rotos} → recortados {cortados} del final, quedan {total-cortados}")
        else:
            print(f"g{n}: rotos {rotos} EN MEDIO ({-cortados}) — hay que volver a animar")
# 0 · dependencias
pip3 install requests pillow   # + el cliente de IA, en la parte reservada opencv-python mediapipe numpy
brew install ffmpeg

# 0b · los modelos de MediaPipe NO están en el repo: se bajan una vez (~12 MB)
mkdir -p ~/Desktop/"Claude Code"/la-carpeta-de-la-cara/modelos && cd $_
curl -LO https://storage.googleapis.com/mediapipe-models/face_landmarker/face_landmarker/float16/1/face_landmarker.task
curl -LO https://storage.googleapis.com/mediapipe-models/hand_landmarker/hand_landmarker/float16/1/hand_landmarker.task

# 1 · bajar los b-rolls de iCloud (si no, ffmpeg lee 0 bytes)
B="/Users/cristobal/Library/Mobile Documents/com~apple~CloudDocs/ACTIVE/Reposters/TANDA VIDEOS - BROLLS "
find "$B" -name "*.MOV" -exec brctl download {} \;

# 2 · refrescar el inventario de carpetas -> brolls.json
cd ~/projects/codigo/tanda-brolls && python3 - <<'EOF'
import json, subprocess, pathlib
M = json.load(open("matriz.json")); out = {}
for n, sub in M["rutas"].items():
    d = pathlib.Path(M["base"]) / sub; cl = []
    if d.is_dir():
        for p in sorted(d.iterdir()):
            if p.suffix.lower() in {".mov", ".mp4"} and not p.name.startswith("."):
                dur = subprocess.run(["ffprobe","-v","error","-show_entries","format=duration",
                                      "-of","csv=p=0",str(p)],capture_output=True,text=True).stdout.strip()
                cl.append({"nombre":p.name,"dur":round(float(dur),1),"mb":round(p.stat().st_size/1e6,1)})
    out[n] = {"sub": sub, "clips": cl}
json.dump(out, open("brolls.json","w"), ensure_ascii=False, indent=2)
EOF

# 3 · meter los vídeos IA y ver el reparto antes de gastar CPU
cp ~/Desktop/mis_videos_ia/*.mp4 ~/projects/codigo/tanda-brolls/entrada_ia/
python3 cruce.py entrada_ia/

# 4 · montar las piezas
python3 monta.py entrada_ia/ --gesto 3 --tope 18

# 5 · revisar lo montado antes de entregarlo (sale 1 si alguna tiene fallo)
python3 revisa.py salida/ && open salida/

# 6 · el fotograma de ejemplo de una frase
python3 -c "import ejemplo_rotulo as e; e.pinta('frame0.jpg','2 años corriendo y NADIE me había dicho ESTO ??!','ejemplo.jpg')"